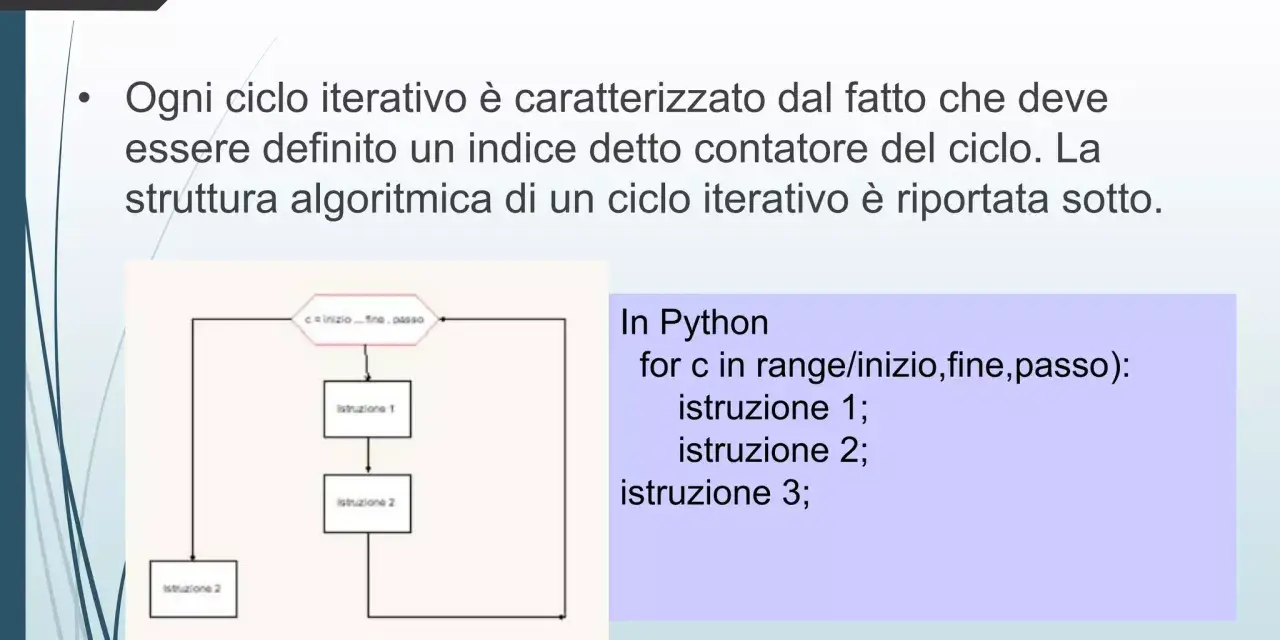
Quando devi attraversare una lista di clienti, elaborare righe lette da un database o controllare ogni elemento di un file, il ciclo for è spesso la soluzione più chiara in Python. In questa guida mostro la sintassi essenziale, l’uso di range(), enumerate() e zip(), l’integrazione con SQLite, gli errori più comuni e i criteri che uso per scrivere loop leggibili ed efficienti.
Il ciclo for rende ordinata l’elaborazione di sequenze e dati
- Iterazione su liste, stringhe, dizionari, file, generatori e risultati di query.
- range() per ripetere un’operazione su una sequenza di numeri senza creare necessariamente una lista completa.
- enumerate() per ottenere indice e valore senza gestire contatori manuali.
- break, continue ed else per controllare con precisione il flusso del loop.
- SQLite per leggere e aggiornare righe usando query parametrizzate e iterazioni sicure.
 5" e "in range(5)" sono elementi chiave per controllare i cicli.">
Capire come funziona davvero il ciclo for
La forma base è semplice e riflette bene la filosofia di Python. La variabile riceve un elemento alla volta dall’oggetto iterabile, cioè da un oggetto che può fornire valori in sequenza.
nomi = ["Luca", "Giulia", "Marco"]

for nome in nomi:
    print(nome)
Il blocco indentato viene eseguito una volta per ogni elemento. In questo caso Python stampa i tre nomi, nell’ordine in cui compaiono nella lista. La indentazione non è decorativa: identifica le istruzioni appartenenti al ciclo.
Il ciclo non lavora soltanto con le liste. Posso attraversare una stringa carattere per carattere, un insieme, una tupla, un dizionario, un file aperto o il risultato progressivo di un generatore.
parola = "Python"

for carattere in parola:
    print(carattere)

prezzi = {"tastiera": 49.90, "mouse": 24.50}

for prodotto in prezzi:
    print(prodotto, prezzi[prodotto])
Quando itero direttamente su un dizionario ottengo le sue chiavi. Se mi servono chiave e valore insieme, preferisco items(), perché rende l’intenzione immediata.
for prodotto, prezzo in prezzi.items():
    print(f"{prodotto}: {prezzo:.2f} euro")
È un dettaglio piccolo, ma fa una differenza concreta nella manutenzione. Un nome come prezzo comunica già che cosa sto elaborando, mentre un indice numerico spesso costringe il lettore a ricostruire la logica.
La sintassi da ricordare
for elemento in iterabile:
    istruzione(elemento)
Dopo for inserisco la variabile temporanea, dopo in l’oggetto da attraversare e alla fine della prima riga il carattere :. Se il corpo contiene più istruzioni, tutte devono avere la stessa indentazione, normalmente di quattro spazi.
Una lista vuota non genera un errore. Il corpo viene semplicemente saltato. Questo comportamento è utile quando una query non restituisce risultati, ma bisogna prevedere cosa mostrare all’utente in quel caso.
Usare range, enumerate e zip senza complicare il codice
Molti esempi introduttivi usano range(), ma il ciclo for di Python non è legato ai numeri. range() crea un iterabile numerico con valore iniziale incluso e limite finale escluso.
for numero in range(5):
    print(numero)
Il risultato va da 0 a 4. Posso indicare anche inizio, fine e passo.
for numero in range(2, 11, 2):
    print(numero)
Qui vengono stampati 2, 4, 6, 8 e 10. Per un conteggio all’indietro basta usare un passo negativo.
for numero in range(10, 0, -2):
    print(numero)
Quando mi serve l’indice di una lista, evito quasi sempre range(len(lista)). La soluzione più leggibile è enumerate(), che restituisce indice e valore insieme.
clienti = ["Alfa", "Beta", "Gamma"]

for indice, cliente in enumerate(clienti, start=1):
    print(f"{indice}. {cliente}")
Il parametro start=1 è utile per presentare numeri naturali all’utente, pur mantenendo l’indicizzazione interna di Python normalmente basata su zero. Questa distinzione previene molti piccoli errori nei report.
Per elaborare due sequenze in parallelo uso zip(). L’iterazione termina quando termina la sequenza più corta, quindi è bene verificare prima che le lunghezze siano coerenti quando i dati hanno valore operativo.
prodotti = ["SSD", "RAM", "Monitor"]
quantita = [4, 8, 2]

for prodotto, numero in zip(prodotti, quantita):
    print(prodotto, numero)
Con strutture più complesse posso combinare le due funzioni.
nomi = ["Luca", "Giulia", "Marco"]
ruoli = ["admin", "editor", "viewer"]

for indice, (nome, ruolo) in enumerate(zip(nomi, ruoli), start=1):
    print(indice, nome, ruolo)
Il mio criterio è pragmatico. Se vedo un contatore aggiornato a mano o una gestione ripetuta degli indici, controllo subito se enumerate() o zip() possono esprimere la stessa logica con meno possibilità di errore.
Portare il ciclo for dentro un database SQLite
Nel lavoro con i database, il loop compare soprattutto quando devo leggere righe e trasformarle in oggetti, report o risposte API. Con il modulo standard sqlite3, il cursore può essere attraversato direttamente.
import sqlite3

connessione = sqlite3.connect("azienda.db")
cursore = connessione.execute(
    "SELECT id, nome, reparto FROM dipendenti ORDER BY nome"
)

for id_dipendente, nome, reparto in cursore:
    print(id_dipendente, nome, reparto)

connessione.close()
Ogni riga viene restituita come una tupla. La tecnica è comoda per dataset moderati e, soprattutto, evita di caricare tutto in memoria in una struttura separata. La documentazione ufficiale di Python presenta proprio l’iterazione sul cursore come uno degli usi naturali di sqlite3.
Filtrare i dati nel posto giusto
Se devo selezionare solo i dipendenti di un reparto, preferisco lasciare il filtro al database invece di leggere tutte le righe e scartarle nel loop.
reparto = "IT"

righe = connessione.execute(
    "SELECT nome, email FROM dipendenti WHERE reparto = ?",
    (reparto,)
)

for nome, email in righe:
    print(f"{nome}: {email}")
Il punto importante è il segnaposto ?. I valori devono essere passati separatamente alla query, mai inseriti concatenando stringhe. Così il codice è più sicuro e il database può gestire correttamente tipi e caratteri speciali.
Aggiornare più record con attenzione
Un ciclo può aggiornare diverse righe, ma spesso executemany() è più adatto perché comunica che la stessa operazione va applicata a molti parametri.
aggiornamenti = [
    ("attivo", 101),
    ("sospeso", 102),
    ("attivo", 103),
]

connessione.executemany(
    "UPDATE account SET stato = ? WHERE id = ?",
    aggiornamenti
)
connessione.commit()
Uso il loop quando ogni riga richiede una decisione diversa o una trasformazione articolata. Per un aggiornamento uniforme, preferisco una singola operazione SQL o executemany(), perché riduce il lavoro lato Python e rende più semplice controllare la transazione.
La regola pratica è questa: filtri, ordinamenti e aggregazioni semplici spettano al database; trasformazioni applicative, validazioni e logica condizionale possono stare nel ciclo. Trasferire migliaia di righe in Python solo per applicare un filtro elementare è una scelta che spesso rallenta inutilmente il programma.
Controllare il flusso con break, continue ed else
Il ciclo può interrompersi prima di esaurire tutti gli elementi. break lo chiude immediatamente, mentre continue salta il resto dell’iterazione corrente e passa alla successiva.
codici = ["A12", "", "B07", "C31"]

for codice in codici:
    if not codice:
        continue

    if codice == "B07":
        print("Codice trovato")
        break

    print(f"Controllo {codice}")
Questo schema è utile per cercare un elemento. Non bisogna però usare break come cerotto per una logica poco chiara. Se il ciclo contiene molti livelli di condizioni, di solito conviene estrarre una funzione con un nome esplicito.
Python supporta anche else associato al ciclo. Il blocco viene eseguito quando il loop termina normalmente, cioè senza incontrare break.
codici = ["A12", "B07", "C31"]
codice_cercato = "Z99"

for codice in codici:
    if codice == codice_cercato:
        print("Trovato")
        break
else:
    print("Codice assente")
Questa forma è elegante per le ricerche, anche se non tutti la riconoscono al primo sguardo. La uso quando chiarisce davvero la differenza tra “trovato” e “lista esaurita”; in codice condiviso, aggiungo spesso un commento breve per evitare ambiguità.
Leggi anche: Comandi DBCC SQL Server per controlli e manutenzione sicura
Gestire i loop annidati
Un loop dentro un altro serve, per esempio, a leggere una tabella rappresentata da liste annidate.
vendite = [
    [120, 90, 110],
    [80, 75, 95],
]

for settimana in vendite:
    totale = 0

    for importo in settimana:
        totale += importo

    print(totale)
Il limite è la complessità. Due livelli sono spesso comprensibili, mentre tre o più livelli possono diventare difficili da testare e rallentare rapidamente. In questi casi valuto una query aggregata, una funzione dedicata o una struttura dati più adatta.
Evitare gli errori che rendono fragile un for
L’errore più frequente è modificare una lista mentre la si attraversa.
numeri = [1, 2, 3, 4, 5]

for numero in numeri:
    if numero % 2 == 0:
        numeri.remove(numero)
Il risultato può sorprendere perché gli elementi cambiano posizione durante l’iterazione. Preferisco creare una nuova lista con una comprensione oppure iterare su una copia.
numeri_dispari = [numero for numero in numeri if numero % 2 != 0]Un altro problema tipico è confondere il valore con l’indice. Scrivere for indice in clienti non produce gli indici, ma gli elementi della lista. Per gli indici usa range() solo quando servono davvero, oppure scegli enumerate().
Bisogna prestare attenzione anche alle variabili definite nel loop. In Python la variabile del ciclo resta disponibile dopo la sua conclusione, ma il suo valore potrebbe non esistere se l’iterabile era vuoto. Per questo evito di usare quella variabile fuori dal blocco come se fosse sempre valorizzata.
| Situazione | Scelta consigliata | Motivo |
|---|---|---|
| Leggere ogni elemento | for elemento in sequenza |
È la forma più diretta e leggibile. |
| Usare indice e valore | enumerate() |
Evita contatori manuali. |
| Associare due sequenze | zip() |
Rende esplicita l’elaborazione parallela. |
| Filtrare o aggregare dati | SQL, quando possibile | Riduce dati trasferiti e lavoro in Python. |
| Ripetere finché non accade qualcosa | while |
La condizione di terminazione è più importante degli elementi. |
Non uso un for solo perché è familiare. Se non so in anticipo quanti tentativi servono e la ripetizione dipende da una condizione, while è più naturale. Se invece ho una sequenza o un flusso di elementi, il ciclo for esprime meglio il problema.
Scrivere loop più rapidi e leggibili
Per trasformazioni semplici, una list comprehension può sostituire un ciclo tradizionale in una sola espressione.
prezzi = [10, 20, 35, 50]
prezzi_scontati = [round(prezzo * 0.90, 2) for prezzo in prezzi]
È una buona scelta quando la logica resta leggibile. Se aggiungo molte condizioni, chiamate esterne o effetti collaterali, il ciclo esplicito torna preferibile. La brevità non deve diventare un ostacolo alla comprensione.
Per grandi quantità di dati considero generatori ed espressioni generatrici.
totale = sum(prezzo * 0.90 for prezzo in prezzi)Qui non creo necessariamente una seconda lista completa. Il valore viene prodotto quando serve, con un uso della memoria più contenuto. Questo approccio è particolarmente interessante quando processo file grandi o molte righe provenienti da un database.
La velocità, comunque, non dipende solo dal ciclo. Una query senza indice, una conversione ripetuta dentro il loop o una chiamata di rete per ogni elemento possono pesare molto più del costrutto for in sé. Prima di ottimizzare misuro il punto lento, poi intervengo sulla causa.
In pratica controllo quattro aspetti. La sorgente dei dati, perché leggere troppo è spesso il problema principale; il numero di operazioni ripetute; la memoria occupata; e la chiarezza del codice per chi dovrà modificarlo tra sei mesi.
Dal primo loop a una base di codice affidabile
Per imparare bene questa costruzione suggerisco di partire da tre esercizi concreti. Attraversare una lista e filtrare valori, associare due collezioni con zip(), poi leggere righe SQLite e produrre un piccolo report. Sono esempi abbastanza semplici da testare, ma vicini a ciò che accade nei progetti reali.
Il principio da portare con sé è essenziale: itera direttamente sui dati quando puoi, usa gli strumenti della libreria standard per indice e sequenze parallele, e lascia al database il lavoro che sa fare meglio. Con questa disciplina, il ciclo for smette di essere una sintassi da memorizzare e diventa uno strumento preciso per trasformare dati senza perdere leggibilità.