Un confronto tra due stringhe che dovrebbe riuscire può fallire per una differenza invisibile: maiuscole, accenti, lingua o regole di ordinamento. Nel lessico tecnico, la combinazione collate sql server richiama proprio la gestione di queste regole, con effetti concreti su ricerche, join, indici e importazioni di dati. Qui chiarisco come funziona la collation, dove viene applicata e come correggere i conflitti senza compromettere il database.
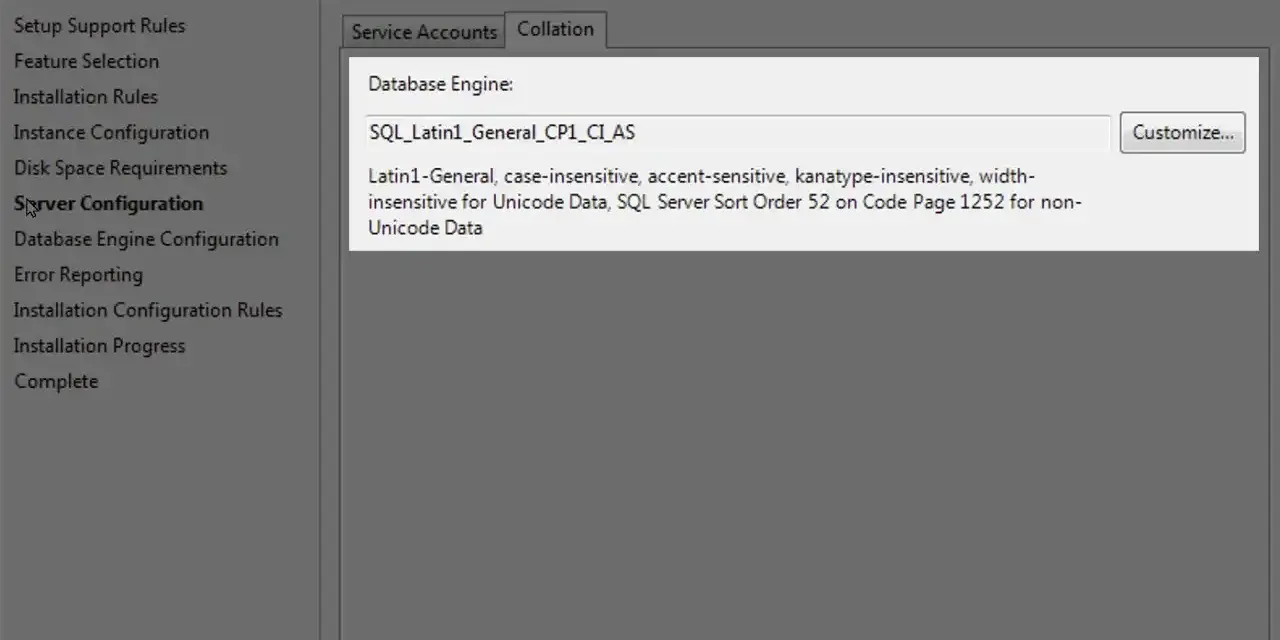
Le regole di confronto decidono come SQL Server legge il testo
- La collation stabilisce confronto, ordinamento e sensibilità a maiuscole e accenti.
- Quattro livelli possono influenzare il risultato: server, database, colonna ed espressione.
- COLLATE permette di applicare una regola specifica a una colonna o a una singola query.
- CI e AI indicano rispettivamente insensibilità a maiuscole e accenti, mentre CS e AS indicano sensibilità.
- Un conflitto di collation si risolve meglio alla radice, non applicando COLLATE indiscriminatamente a ogni query.
Che cos’è la collation e perché cambia i risultati
La collation è l’insieme di regole che SQL Server usa per confrontare e ordinare dati testuali. Determina, per esempio, se “Milano” e “milano” sono considerate uguali, se “caffè” coincide con “caffe” e in quale ordine compaiono le parole in un risultato.
Non riguarda soltanto la visualizzazione. Una collation può cambiare il comportamento di operatori come =, LIKE, ORDER BY e delle condizioni usate nei JOIN. È uno di quei dettagli che spesso resta invisibile fino al giorno in cui un’importazione o una ricerca restituisce risultati inattesi.
Come leggere il nome di una collation
| Sigla | Significato | Esempio pratico |
|---|---|---|
| CI | Case insensitive | “Roma” e “roma” coincidono |
| CS | Case sensitive | “Roma” e “roma” sono diverse |
| AI | Accent insensitive | “perché” e “perche” coincidono |
| AS | Accent sensitive | Gli accenti vengono distinti |
| BIN2 | Confronto binario | Confronto basato sui valori codificati |
| UTF8 | Codifica UTF-8 per colonne compatibili | Utile con colonne varchar multilingua |
Per un’applicazione italiana, una collation CI è spesso più comoda per login, email e ricerche normali. La scelta AI o AS dipende invece dal dominio: in una ricerca libera può essere utile ignorare gli accenti, mentre in un archivio linguistico o giuridico la distinzione può avere valore.
Dove viene applicata in SQL Server
La collation non esiste in un solo punto. SQL Server può ereditarla dal server, dal database o dalla colonna, mentre una clausola COLLATE applicata nella query può modificarla temporaneamente. Questa gerarchia spiega molti errori che, a prima vista, sembrano casuali.
Server, database e colonne
- Livello server - è il valore predefinito dell’istanza e influenza database di sistema, variabili e oggetti temporanei.
- Livello database - diventa il valore predefinito per le nuove colonne create nel database.
- Livello colonna - definisce la regola effettiva con cui viene gestita una specifica colonna testuale.
- Livello espressione - vale solo per il risultato di una query o per un confronto puntuale.
Per controllare le impostazioni attive uso normalmente queste interrogazioni:
SELECT SERVERPROPERTY('Collation') AS ServerCollation;

SELECT
    name,
    collation_name
FROM sys.databases;

SELECT
    c.name AS ColumnName,
    c.collation_name
FROM sys.columns AS c
WHERE c.object_id = OBJECT_ID('dbo.Clienti');
Il caso più insidioso coinvolge tempdb. Una tabella temporanea può ereditare la collation dell’istanza, mentre le colonne della tabella permanente usano quella del database applicativo. Quando vengono confrontate, SQL Server può restituire l’errore “Cannot resolve the collation conflict”.
Come usare COLLATE nelle query senza creare nuovi problemi
La clausola COLLATE consente di applicare una collation a un’espressione, a una definizione di colonna o a un database. È molto utile per una correzione mirata, ma io la considero una leva di precisione, non una soluzione da aggiungere automaticamente a ogni confronto.
Confrontare testi con regole diverse
SELECT *
FROM dbo.Clienti
WHERE Cognome COLLATE Latin1_General_100_CI_AI = N'Bianchi';
In questo esempio il confronto ignora maiuscole e accenti. La modifica vale solo per quella condizione e non cambia la struttura della tabella. È una buona scelta quando si deve gestire una ricerca specifica o una migrazione ancora in corso.
Risolvere un conflitto tra tabelle
SELECT a.Id, a.Codice
FROM dbo.Ordini AS a
INNER JOIN #Import AS b
    ON a.Codice COLLATE DATABASE_DEFAULT
     = b.Codice COLLATE DATABASE_DEFAULT;
DATABASE_DEFAULT chiede a SQL Server di usare la collation predefinita del database corrente. È spesso più mantenibile di un nome scritto a mano, soprattutto quando lo stesso codice viene eseguito in ambienti di sviluppo, test e produzione con impostazioni diverse.
Il compromesso riguarda le prestazioni. Se si applica COLLATE direttamente alla colonna indicizzata dentro un WHERE o un JOIN, l’ottimizzatore potrebbe non riuscire a usare l’indice nel modo più efficiente. Su tabelle grandi, preferisco correggere la colonna o allineare lo schema invece di mascherare continuamente il problema nella query.
Come scegliere e cambiare la collation corretta
Non esiste una collation universalmente migliore. La decisione dipende dalla lingua dei dati, dalla sensibilità richiesta e dai sistemi con cui il database deve comunicare. Per un nuovo progetto definisco la regola prima di creare tabelle e indici, perché cambiarla dopo può richiedere una migrazione complessa.
| Scenario | Scelta da valutare | Attenzione principale |
|---|---|---|
| Gestionale italiano con ricerche comuni | Collation Windows moderna, CI e spesso AI | Verificare come gestire nomi e accenti |
| Dati internazionali | Collation Unicode coerente con l’applicazione | Testare lingue, simboli e ordinamenti |
| Codici tecnici o identificativi | CS o BIN2 quando la distinzione è significativa | “abc” e “ABC” potrebbero essere codici diversi |
| Colonne varchar multilingua | Collation con supporto UTF-8 nelle versioni compatibili | Controllare lunghezza, driver e applicazioni client |
Cambiare il database
Per impostare la collation predefinita di un nuovo database si può usare una sintassi di questo tipo:
CREATE DATABASE Archivio
COLLATE Latin1_General_100_CI_AI;
Modificare la collation del database in uso è più delicato. L’operazione non riscrive automaticamente ogni colonna già esistente, né risolve tutti i conflitti presenti in tabelle, indici e oggetti. Prima di procedere verifico dipendenze, vincoli, viste, procedure e dati reali.
Leggi anche: Grafica con Python - librerie, grafici e interfacce
Cambiare una colonna esistente
ALTER TABLE dbo.Clienti
ALTER COLUMN Cognome nvarchar(100)
COLLATE Latin1_General_100_CI_AI NOT NULL;
La sintassi è semplice, ma l’operazione può fallire se la colonna è coinvolta in indici, vincoli, colonne calcolate o altri oggetti dipendenti. Inoltre, la nuova regola può modificare l’unicità percepita da un indice. Due valori prima distinti potrebbero diventare equivalenti dopo il passaggio a una collation CI o AI.
Gli errori più comuni e il modo migliore per evitarli
Il primo errore è scegliere una collation solo perché è quella predefinita dell’installazione. Il valore iniziale può dipendere dal sistema operativo o dalla configurazione del server e non riflettere affatto la lingua dell’applicazione.
Il secondo è confondere Unicode e collation. Usare nvarchar aiuta a rappresentare un insieme ampio di caratteri, ma non decide se il confronto debba ignorare maiuscole o accenti. Sono due problemi distinti e vanno testati separatamente.
- Non cambiare il server alla leggera per correggere una sola tabella.
- Non applicare COLLATE ovunque senza controllare l’uso degli indici.
- Non ignorare tempdb quando il conflitto compare solo con tabelle temporanee.
- Non testare soltanto con caratteri ASCII, perché gli errori emergono spesso con à, è, ß, emoji o alfabeti non latini.
- Non dimenticare i vincoli UNIQUE, che possono comportarsi diversamente dopo una modifica.
Nel mio controllo finale preparo sempre una piccola matrice di test con maiuscole, accenti, caratteri speciali e valori quasi identici. Bastano poche decine di righe ben scelte per scoprire se la collation rispecchia davvero il comportamento atteso dall’applicazione.
La regola da fissare prima di progettare lo schema
La scelta più solida è stabilire una collation coerente per il database, usare colonne Unicode quando i dati lo richiedono e riservare COLLATE alle eccezioni documentate. In questo modo le query restano leggibili, gli indici lavorano meglio e i conflitti tra tabelle diventano molto meno probabili.
Se il database esiste già, procederei per gradi. Prima misurerei le collation presenti, poi isolerei le colonne problematiche e infine testerei la migrazione su una copia dei dati. Una modifica consapevole vale più di una correzione rapida, soprattutto quando il database contiene milioni di righe o supporta applicazioni diverse.