Quando un programma deve associare un nome a un valore, un codice prodotto a un prezzo o una configurazione a un’impostazione, gli indici numerici di una lista diventano presto scomodi. Il dizionario Python risolve proprio questo problema con una struttura basata su coppie chiave-valore, utile tanto negli script quotidiani quanto nelle applicazioni che elaborano dati provenienti da API, file JSON e database.
Le regole essenziali per usare i dizionari con sicurezza
- Chiavi uniche e valori modificabili: ogni chiave identifica un solo dato.
-
Accesso diretto con la sintassi
dati[chiave], oppure conget()per evitare errori. -
Iterazione più leggibile usando
items(),keys()evalues(). -
Comprehension e operatori
|consentono di creare e unire strutture in modo compatto. - Chiavi immutabili: stringhe, numeri e tuple adatte, liste e dizionari no.
- Uso con JSON e database pratico, ma non sostitutivo di un archivio persistente.
Che cos’è un dizionario Python e quando conviene usarlo
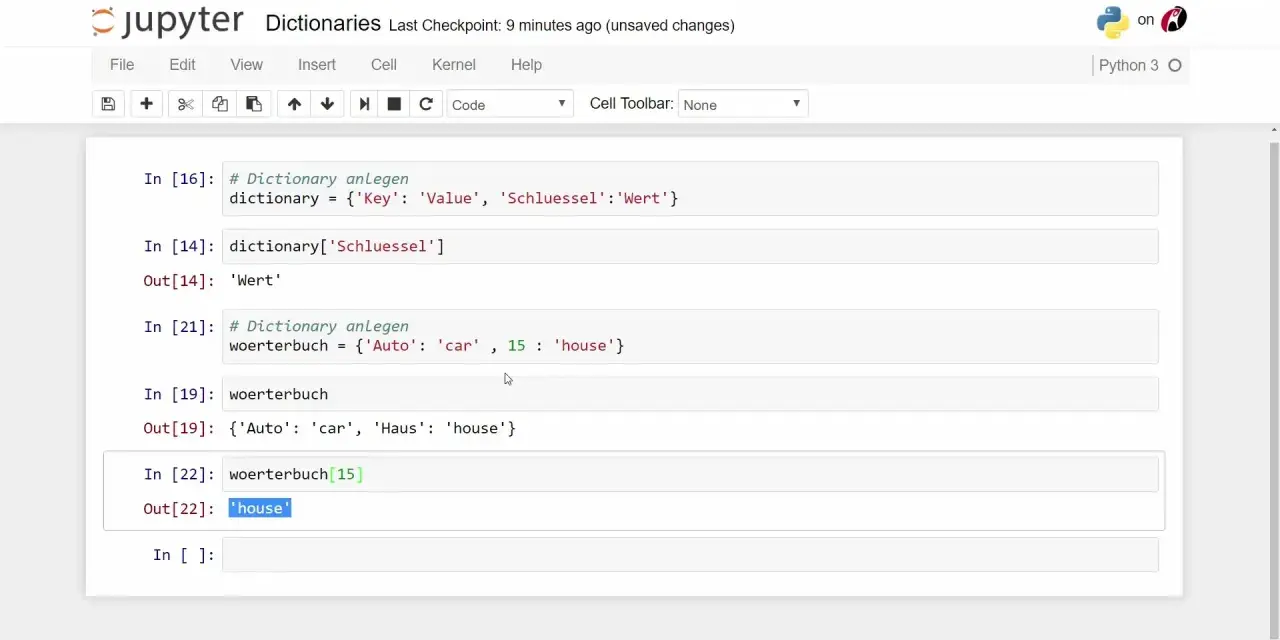
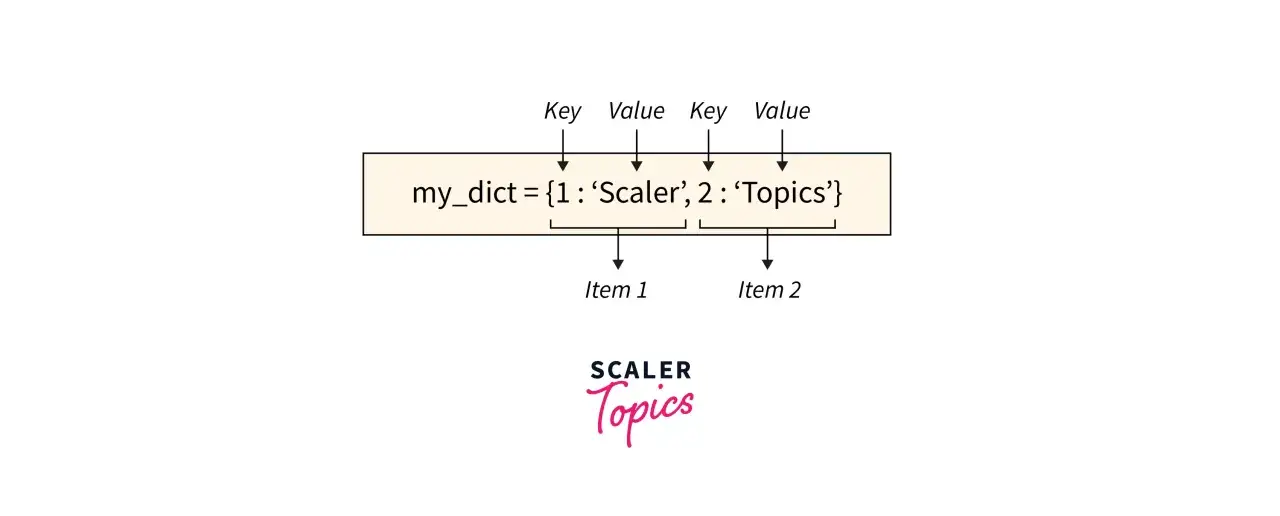
Un dizionario è una struttura dati mutabile che memorizza elementi nella forma chiave: valore. La chiave è l’etichetta con cui si recupera un’informazione, mentre il valore può essere quasi qualsiasi oggetto Python, compreso un altro dizionario, una lista o una funzione.
utente = {
    "nome": "Giulia",
    "eta": 32,
    "iscritto": True
}
In questo caso non devo ricordare che il nome si trova nella posizione 0 e l’età nella posizione 1. Scrivo semplicemente utente["nome"]. È questo il vantaggio che, nella mia esperienza, fa la differenza nei progetti reali: il codice descrive il significato del dato invece della sua posizione.
Le chiavi devono essere uniche e utilizzabili per il calcolo hash. In pratica funzionano stringhe, numeri, valori booleani e tuple composte a loro volta da elementi immutabili. Liste, set e altri dizionari non possono essere chiavi perché il loro contenuto può cambiare.
| Struttura | Accesso | Uso tipico |
|---|---|---|
list |
Indice numerico | Sequenze ordinate di elementi |
tuple |
Indice numerico | Dati ordinati e non modificabili |
set |
Appartenenza | Elementi unici senza coppie chiave-valore |
dict |
Chiave | Associazioni semantiche tra dati |
Dal punto di vista delle prestazioni, la ricerca di una chiave richiede in media tempo O(1). Non significa che ogni operazione sia sempre istantanea, ma che il dizionario è generalmente più adatto di una lista quando devo cercare spesso un elemento attraverso un identificatore.
Come creare, leggere e modificare i dati
Il modo più semplice per creare una struttura vuota è usare {}. Per inserire un elemento assegno un valore a una nuova chiave, mentre una chiave già presente viene aggiornata.
profili = {}

profili["nome"] = "Luca"
profili["ruolo"] = "sviluppatore"
profili["ruolo"] = "data engineer"

print(profili)
Per leggere un valore posso usare le parentesi quadre. Se la chiave non esiste, però, Python solleva un’eccezione KeyError. Quando l’assenza del dato è possibile e normale, preferisco get().
config = {
    "tema": "scuro",
    "timeout": 30
}

print(config["timeout"])
print(config.get("lingua"))
print(config.get("lingua", "it"))
Il secondo argomento di get() è il valore predefinito. Questa piccola scelta rende il programma più robusto, soprattutto quando i dati arrivano da un’API esterna o da un file in cui alcuni campi possono mancare.
Leggi anche: Creare un’app Android con Python - Kivy, SQLite e APK
Aggiungere, aggiornare e rimuovere elementi
Per eliminare una coppia posso usare del, oppure pop() quando mi serve anche il valore rimosso. Il metodo pop() accetta un valore predefinito e può quindi evitare un errore se la chiave non è presente.
carrello = {
    "mouse": 24.90,
    "tastiera": 49.90
}

prezzo = carrello.pop("mouse")
carrello["monitor"] = 189.00

del carrello["tastiera"]
Per aggiornare più coppie insieme uso update(). Il metodo modifica il dizionario esistente, quindi è diverso dalla creazione di una nuova copia.
impostazioni = {"lingua": "it", "notifiche": True}

impostazioni.update({
    "notifiche": False,
    "fuso_orario": "Europe/Rome"
})
Per svuotare completamente la struttura c’è clear(). Se invece devo duplicarla, ricordo che copy() produce una copia superficiale: gli oggetti annidati restano condivisi. Per strutture profonde serve valutare copy.deepcopy(), con il relativo costo di memoria e di elaborazione.
Metodi fondamentali e iterazione senza errori
Un dizionario si attraversa con un ciclo for. Iterando direttamente ottengo le chiavi, che spesso è sufficiente per verificare la presenza di un elemento.
prezzi = {
    "pane": 1.50,
    "latte": 1.80,
    "caffè": 3.20
}

for prodotto in prezzi:
    print(prodotto)
Quando mi servono sia chiave sia valore, uso items(). È la forma più chiara per elaborare coppie e riduce gli accessi ripetuti alla struttura.
for prodotto, prezzo in prezzi.items():
    print(f"{prodotto}: {prezzo:.2f} euro")
Gli altri due metodi principali sono keys() e values(). Restituiscono viste dinamiche del dizionario, non liste indipendenti. Se mi serve una lista vera, posso convertirle con list().
nomi = list(prezzi.keys())
valori = list(prezzi.values())

if "caffè" in prezzi:
    print("Prodotto disponibile")
Il test con in controlla le chiavi, non i valori. Per cercare un prezzo specifico devo usare prezzo in prezzi.values(). È un errore comune, soprattutto quando si passa da una lista a una struttura associativa.
Le chiavi mantengono l’ordine di inserimento nelle versioni moderne di Python, con garanzia del linguaggio a partire da Python 3.7. Questo non equivale a un ordinamento alfabetico. Per ottenere le chiavi ordinate uso sorted(dati), mentre per ordinare le coppie posso specificare una funzione chiave.
vendite = {
    "Roma": 420,
    "Milano": 610,
    "Napoli": 280
}

ordinate = sorted(vendite.items(), key=lambda coppia: coppia[1], reverse=True)
print(ordinate)
Comprehension, dizionari annidati e fusione
Le dictionary comprehension sono utili quando la regola di costruzione è breve e leggibile. Permettono di generare chiavi e valori in una sola espressione, senza trasformare il codice in una scorciatoia difficile da mantenere.
quadrati = {numero: numero ** 2 for numero in range(1, 6)}

pari = {
    numero: numero ** 2
    for numero in range(1, 11)
    if numero % 2 == 0
}
Io le uso soprattutto per trasformazioni semplici. Se la comprehension richiede più condizioni, chiamate di funzione e logica annidata, preferisco un ciclo esplicito: qualche riga in più spesso rende il programma molto più facile da controllare.
I dizionari annidati rappresentano dati strutturati, per esempio il profilo di un cliente o una risposta JSON. L’accesso avviene concatenando le chiavi, ma conviene verificare i livelli opzionali prima di arrivare al dato finale.
azienda = {
    "nome": "Alba Tech",
    "sede": {
        "città": "Torino",
        "cap": "10100"
    }
}

città = azienda["sede"]["città"]
Per unire due dizionari posso usare l’operatore |, disponibile da Python 3.9. Se la stessa chiave appare in entrambi, prevale il valore del dizionario a destra.
base = {"timeout": 10, "debug": False}
locale = {"debug": True, "lingua": "it"}

configurazione = base | locale
Se desidero modificare il primo dizionario direttamente, uso |=. L’alternativa {**base, **locale} resta utile quando lavoro con versioni precedenti, ma oggi l’operatore dedicato è più leggibile.
Dal JSON al database senza confondere i ruoli
Il legame tra dizionari e JSON è naturale perché entrambi rappresentano dati tramite nomi e valori. Un oggetto JSON diventa normalmente un dizionario Python dopo il caricamento, anche se i tipi disponibili non coincidono perfettamente.
import json

testo = '{"utente": "Marta", "attivo": true, "punti": 85}'
dati = json.loads(testo)

print(dati["utente"])
print(dati["punti"])
Quando salvo il contenuto su file posso usare json.dump(). Devo però ricordare che JSON richiede una struttura serializzabile: oggetti come set, funzioni o istanze personalizzate non vengono convertiti automaticamente.
with open("profilo.json", "w", encoding="utf-8") as file:
    json.dump(dati, file, ensure_ascii=False, indent=2)
Con un database, il dizionario è spesso un ottimo contenitore temporaneo per una riga, per i parametri di una query o per i risultati di un’API. Non lo considero invece un sostituto di SQLite, PostgreSQL o di un altro database quando servono persistenza, concorrenza, indici e transazioni.
import sqlite3

connessione = sqlite3.connect("app.db")
cursore = connessione.cursor()

cursore.execute(
    "SELECT nome, email FROM utenti WHERE stato = :stato",
    {"stato": "attivo"}
)

righe = cursore.fetchall()
connessione.close()
Qui il dizionario rende i parametri nominati più leggibili e riduce il rischio di costruire query concatenando stringhe. La protezione dalle SQL injection dipende comunque dall’uso corretto dei parametri del driver, non dal dizionario in sé.
Gli errori che rallentano i primi programmi
Il primo errore consiste nell’usare una lista come chiave. Python restituisce TypeError: unhashable type perché una lista può cambiare. Se devo rappresentare una coordinata o una combinazione fissa, posso usare una tupla.
# Non valido
# posizioni = {[10, 20]: "punto"}

# Valido
posizioni = {(10, 20): "punto"}
Un altro problema è modificare il dizionario mentre lo percorro. L’operazione può generare un errore oppure produrre risultati inattesi. La soluzione semplice è iterare su una copia delle chiavi o costruire una nuova struttura.
utenti = {"a": 18, "b": 25, "c": 16}

maggiorenni = {
    nome: eta
    for nome, eta in utenti.items()
    if eta >= 18
}
Faccio attenzione anche a setdefault(). Può essere comodo per inizializzare una lista, ma se usato senza criterio nasconde la logica e crea valori di default non necessari.
gruppi = {}

for nome, reparto in [
    ("Anna", "sviluppo"),
    ("Paolo", "sviluppo"),
    ("Elisa", "marketing")
]:
    gruppi.setdefault(reparto, []).append(nome)
Per casi più articolati esiste collections.defaultdict, mentre Counter è più adatto a contare elementi. Sono strumenti pratici, ma scelgo sempre il tipo in base al problema: un normale dict resta spesso la soluzione più chiara.
Infine, non uso un dizionario solo perché è flessibile. Se i dati devono avere ordine fisso e pochi campi, una tupla o una dataclass può comunicare meglio la struttura. La flessibilità è un vantaggio finché non diventa assenza di regole.
Un criterio semplice per scegliere la struttura giusta
Quando progetto una funzione, mi chiedo prima che cosa rappresenta ogni dato. Se devo recuperare rapidamente un valore attraverso un identificatore, scelgo il dizionario; se devo elaborare una sequenza, parto da una lista; se devo garantire immutabilità, considero una tupla.
Per lavorare bene con questa struttura bastano poche abitudini solide: usare chiavi descrittive, gestire esplicitamente i campi mancanti con get(), iterare con items() e non nascondere logiche complesse dentro comprehension troppo lunghe. Sono dettagli piccoli, ma nel codice che cresce fanno una differenza concreta.
Il dizionario è uno dei mattoni più utili di Python perché collega dati e significato in modo diretto. Una volta compresi accesso, aggiornamento, iterazione, annidamento e serializzazione, diventa naturale usarlo per configurazioni, API, JSON, report e parametri database senza perdere chiarezza.