Hai mai creato una classe Python che dovrebbe comportarsi come una lista, un numero o una riga di database, ma finisci per chiamare metodi personalizzati per ogni operazione? I dunder methods in Python, cioè i metodi racchiusi tra doppie parentesi basse, permettono di integrare le tue classi con la sintassi naturale del linguaggio. Qui mostro come funzionano, quali usare davvero e come applicarli a oggetti utili anche nella programmazione con database.
Le regole essenziali per usare bene i metodi speciali
-
Definizione I dunder methods iniziano e finiscono con due underscore, come
__init__e__str__. -
Attivazione automatica Python li richiama tramite operazioni comuni come
+,len(),forewith. - Classe, non istanza I metodi speciali devono essere definiti normalmente nella classe per essere riconosciuti in modo affidabile dall’interprete.
-
Database
__getitem__,__iter__,__len__e__repr__sono particolarmente utili per modellare righe e risultati di query. - Prudenza Non tutti i dunder methods servono in ogni classe. Implementare quelli sbagliati può rendere il codice ambiguo o difficile da mantenere.
Che cosa sono davvero i dunder methods
Il termine “dunder” nasce da double underscore, ovvero doppio underscore. Un metodo come __len__ non è pensato, di norma, per essere chiamato direttamente: Python lo usa quando scrivi len(oggetto).
Questo meccanismo fa parte del data model di Python, l’insieme delle regole che stabilisce come gli oggetti partecipano alle operazioni del linguaggio. In pratica, una classe può dichiarare il proprio comportamento senza obbligare chi la usa a imparare un’API diversa per ogni oggetto.
class Prodotto:
    def __init__(self, nome, prezzo):
        self.nome = nome
        self.prezzo = prezzo

    def __str__(self):
        return f"{self.nome} - {self.prezzo:.2f} €"

prodotto = Prodotto("Tastiera", 49.90)

print(prodotto)
Quando esegui print(prodotto), Python cerca __str__ e usa il testo restituito. Senza questo metodo vedresti una rappresentazione tecnica dell’oggetto, spesso poco utile a chi sta leggendo un log o una schermata.
Io considero i dunder methods una specie di contratto con il linguaggio. Se implementi __iter__, stai dicendo che l’oggetto può essere attraversato; se implementi __enter__ e __exit__, dichiari che può gestire correttamente un blocco with.
Metodi speciali e metodi normali non sono la stessa cosa
Un metodo normale viene invocato esplicitamente, per esempio cliente.salva(). Un metodo speciale viene invece attivato da una sintassi o da una funzione incorporata, come cliente[0], len(cliente) o cliente == altro_cliente.
Python cerca questi metodi soprattutto sulla classe dell’oggetto. Per questo assegnare dinamicamente obj.__len__ a una singola istanza non è un modo affidabile per rendere funzionante len(obj). La definizione deve stare nella classe.
Il ciclo di vita di un oggetto
I primi metodi che si incontrano sono __new__, __init__ e __del__. Sembrano simili, ma hanno responsabilità diverse e confonderle può produrre bug sottili, soprattutto quando si lavora con connessioni, cache o risorse esterne.
| Metodo | Quando interviene | Uso tipico |
|---|---|---|
__new__ |
Prima della creazione dell’istanza | Controllo della costruzione, singleton, classi immutabili |
__init__ |
Dopo la creazione dell’istanza | Inizializzazione degli attributi |
__del__ |
Quando l’oggetto viene finalizzato | Uso raro e non adatto alla gestione affidabile delle risorse |
Nella maggior parte delle classi ti basta __init__. Questo metodo riceve l’istanza già creata e prepara il suo stato interno. Non restituisce nulla, quindi inserire return self è un errore.
class ConnessioneDatabase:
    def __init__(self, host, porta=5432):
        self.host = host
        self.porta = porta
        self.connessa = False

    def apri(self):
        self.connessa = True
__new__ serve invece quando devi controllare la fase in cui Python crea l’oggetto. È necessario, per esempio, con tipi immutabili come tuple o str, oppure per implementare schemi di costruzione particolari. Non lo userei per semplice inizializzazione, perché aggiunge complessità senza un vantaggio concreto.
Per chiudere file e connessioni preferisco un context manager con __enter__ e __exit__. Affidarsi a __del__ è rischioso: il momento della finalizzazione non è garantito e gli errori durante la chiusura possono restare nascosti.
Rappresentazione, confronto e valore degli oggetti
Una classe ben progettata dovrebbe spiegare se stessa quando compare in un log o in un debugger. Qui entrano in gioco __repr__ e __str__, che hanno obiettivi diversi.
-
__str__produce una forma leggibile per l’utente. -
__repr__produce una forma utile allo sviluppatore, idealmente precisa e non ambigua. -
__eq__definisce quando due istanze sono considerate uguali. -
__hash__consente l’uso dell’oggetto in set e come chiave di dizionario, ma solo se il suo valore non cambia in modo incompatibile.
class RigaOrdine:
    def __init__(self, prodotto_id, quantita, prezzo):
        self.prodotto_id = prodotto_id
        self.quantita = quantita
        self.prezzo = prezzo

    def __repr__(self):
        return (
            f"RigaOrdine(prodotto_id={self.prodotto_id!r}, "
            f"quantita={self.quantita!r}, prezzo={self.prezzo!r})"
        )

    def __str__(self):
        totale = self.quantita * self.prezzo
        return f"Prodotto {self.prodotto_id}: {totale:.2f} €"

    def __eq__(self, other):
        if not isinstance(other, RigaOrdine):
            return NotImplemented
        return (
            self.prodotto_id == other.prodotto_id
            and self.quantita == other.quantita
            and self.prezzo == other.prezzo
        )
Il valore NotImplemented è importante. Non significa che i due oggetti siano diversi: comunica a Python che il confronto con quel tipo non è supportato e lascia all’interprete la possibilità di provare l’operazione inversa o produrre il risultato corretto.
Confrontare prezzi memorizzati come float può introdurre problemi di precisione. In un gestionale reale userei Decimal oppure importi interi espressi in centesimi. Un dunder method rende l’interfaccia più elegante, ma non risolve da solo le scelte sul modello dei dati.
Se definisci __eq__, rifletti prima sull’identità dell’oggetto. Due righe con lo stesso identificativo primario sono necessariamente uguali, oppure devono coincidere anche quantità e prezzo? Questa decisione influenza test, cache e confronti tra risultati provenienti da database diversi.
Comportarsi come una collezione
Quando una classe contiene più valori, i metodi speciali possono farla sembrare una sequenza naturale. I più utili sono __getitem__ per l’accesso con parentesi quadre, __len__ per la lunghezza, __iter__ per l’iterazione e __contains__ per l’operatore in.
class RisultatoQuery:
    def __init__(self, righe):
        self._righe = list(righe)

    def __getitem__(self, indice):
        return self._righe[indice]

    def __len__(self):
        return len(self._righe)

    def __iter__(self):
        return iter(self._righe)

    def __contains__(self, riga):
        return riga in self._righe

risultato = RisultatoQuery([
    {"id": 1, "nome": "Mouse"},
    {"id": 2, "nome": "Monitor"},
])

print(len(risultato))
print(risultato[0]["nome"])

for riga in risultato:
    print(riga["id"])
Questo esempio è interessante per un progetto che legge dati da SQLite, PostgreSQL o MySQL. Il chiamante vede una collezione coerente e non deve sapere se sotto c’è una lista, un cursore già consumato o una struttura costruita da un ORM.
Leggi anche: Interfaccia grafica Python - quale toolkit scegliere?
Una riga di database accessibile per indice e nome
Per rappresentare una singola riga si può offrire un’interfaccia simile a quella di un dizionario. Bisogna però mantenere un comportamento prevedibile: se una colonna non esiste, è meglio sollevare KeyError invece di restituire silenziosamente None.
class Record:
    def __init__(self, valori):
        self._valori = dict(valori)

    def __getitem__(self, chiave):
        return self._valori[chiave]

    def __iter__(self):
        return iter(self._valori)

    def __len__(self):
        return len(self._valori)

    def __repr__(self):
        return f"Record({self._valori!r})"

record = Record({"id": 7, "email": "utente@example.it"})

print(record["email"])
Io aggiungerei metodi speciali solo quando l’analogia è chiara. Se l’oggetto non è realmente una sequenza o una mappa, forzare l’uso di [] può rendere l’API piacevole all’inizio e confusa dopo qualche mese.
Operatori, chiamate e gestione delle risorse
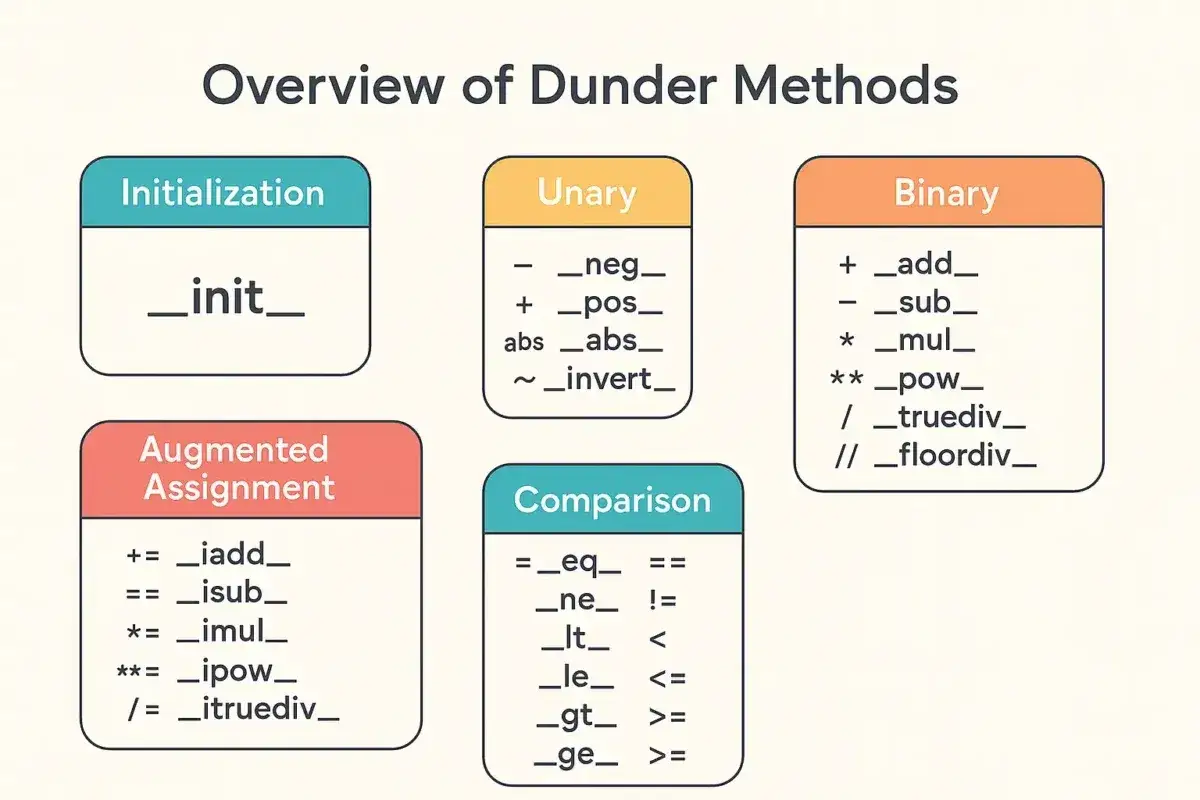
I dunder methods permettono di personalizzare anche operatori e comportamenti avanzati. Alcuni esempi frequenti sono __add__ per +, __lt__ per <, __bool__ per la valutazione booleana e __call__ per rendere un’istanza invocabile come una funzione.
| Sintassi | Metodo associato | Esempio utile |
|---|---|---|
a + b |
__add__ |
Somma di importi o vettori |
a < b |
__lt__ |
Ordinamento di record |
if oggetto |
__bool__ |
Oggetto valido o risultato non vuoto |
oggetto() |
__call__ |
Wrapper, validatori e client configurabili |
with oggetto |
__enter__, __exit__
|
Transazioni e connessioni |
Un context manager è particolarmente adatto alle transazioni. L’idea è semplice: entrando nel blocco si prepara la risorsa, uscendo si esegue il commit oppure il rollback in caso di eccezione.
class Transazione:
    def __init__(self, connessione):
        self.connessione = connessione

    def __enter__(self):
        return self.connessione

    def __exit__(self, tipo_errore, valore, traceback):
        if tipo_errore is None:
            self.connessione.commit()
        else:
            self.connessione.rollback()
        return False
Il valore False restituito da __exit__ lascia propagare l’eccezione. Restituire True la sopprimerebbe, una scelta che userei solo se l’errore fosse gestito intenzionalmente e documentato.
Il vantaggio pratico è notevole: il codice applicativo descrive l’operazione, mentre la classe protegge la risorsa. Rimane comunque necessario verificare il comportamento della libreria database usata, perché autocommit, transazioni annidate e gestione del cursore non sono identici in tutti i driver.
Gli errori che rendono i metodi speciali controproducenti
Il primo errore è chiamare un metodo speciale direttamente ovunque. Scrivere obj.__str__() può funzionare, ma normalmente è più corretto usare str(obj), così il codice rispetta il protocollo previsto da Python e gestisce meglio ereditarietà e tipi compatibili.
Un secondo problema nasce dai ritorni errati. __len__ deve restituire un intero non negativo, __str__ una stringa, __iter__ un iteratore e __enter__ l’oggetto che vuoi ricevere dopo as. Errori piccoli producono eccezioni lontane dal punto in cui il metodo è stato scritto.
-
Non usare
__del__per chiusure critiche. Preferisciwitho un metodo esplicito comeclose(). -
Non alterare il significato degli operatori. Se
+esegue una query lenta, l’interfaccia diventa sorprendente. - Non nascondere errori di schema. Un accesso a una colonna inesistente non dovrebbe trasformarsi automaticamente in un valore vuoto.
-
Non creare ricorsione involontaria. Dentro
__getattribute__o__setattr__usa la logica della classe base quando devi accedere agli attributi interni. -
Testa i protocolli. Verifica non solo il metodo isolato, ma anche espressioni come
len(obj),list(obj),obj[0]ewith obj.
Un aspetto che spesso sorprende è che i metodi speciali possono essere cercati in modo diverso dalle normali chiamate di attributo. Per questo modificare un dunder method su una singola istanza non garantisce che la sintassi implicita lo utilizzi.
La mia regola è pratica: implemento prima i metodi che migliorano davvero leggibilità e integrazione, come __repr__, __iter__ o __enter__. Lascio gli hook più avanzati, come __getattribute__ e __getattr__, a casi in cui esiste un requisito preciso e una buona copertura di test.
Un criterio semplice per scegliere il metodo giusto
Prima di aggiungere un dunder method, chiediti quale operazione naturale vuoi rendere possibile. Se la risposta è “voglio leggere una riga per nome”, __getitem__ può avere senso; se è “voglio eseguire una procedura”, un metodo normale con un nome esplicito sarà quasi sempre più chiaro.
| Esigenza | Metodo da valutare | Domanda di controllo |
|---|---|---|
| Mostrare l’oggetto nei log | __repr__ |
La rappresentazione aiuta a diagnosticare il problema? |
Supportare un ciclo for
|
__iter__ |
L’oggetto rappresenta davvero una collezione? |
Gestire with
|
__enter__, __exit__
|
Esiste una risorsa da aprire e chiudere? |
| Confrontare istanze | __eq__ |
Quali campi definiscono l’uguaglianza? |
| Accesso con parentesi quadre | __getitem__ |
L’oggetto è una mappa o una sequenza riconoscibile? |
Nel codice che dialoga con un database, questa selezione conta più della quantità di metodi implementati. Una piccola classe con tre protocolli coerenti è spesso più solida di un oggetto che simula contemporaneamente una lista, un dizionario, un cursore e un servizio remoto.
Dal codice funzionante a un’API Python affidabile
I dunder methods sono potenti perché trasformano operazioni tecniche in comportamenti naturali. La qualità, però, dipende dalla coerenza: la sintassi deve suggerire correttamente il costo e l’effetto dell’operazione, soprattutto quando dietro l’oggetto ci sono query, rete o filesystem.
Per iniziare, implementerei __init__ per lo stato, __repr__ per il debugging e soltanto dopo i protocolli che servono davvero. Con questo approccio le classi restano leggibili, i test sono più semplici e l’integrazione con codice Python esistente diventa naturale.
La domanda decisiva non è quanti metodi speciali conosci, ma se l’oggetto che stai progettando si comporta davvero come ciò che la sintassi Python lascia intendere. Quando la risposta è sì, i dunder methods smettono di sembrare magia e diventano uno strumento preciso per costruire software più espressivo, anche davanti a una tabella di database.