Quando una modifica al database produce un risultato inatteso, il comando ROLLBACK SQL può riportare la transazione allo stato precedente, ma solo se viene usato nelle condizioni corrette. In questa guida mostro come annullare inserimenti, aggiornamenti e cancellazioni, come lavorare con i savepoint e quali differenze considerare tra PostgreSQL, MySQL e SQL Server.
Il rollback funziona solo prima del commit e dentro una transazione controllata
- ROLLBACK annulla le modifiche della transazione corrente.
- COMMIT rende permanenti i cambiamenti e impedisce il semplice annullamento.
- Con autocommit attivo, ogni istruzione può essere confermata subito.
- SAVEPOINT permette di cancellare solo una parte del lavoro.
- Il comportamento cambia in base al database engine e al tipo di tabella o istruzione usata.
Che cosa annulla davvero ROLLBACK
ROLLBACK interrompe la transazione attiva e scarta le modifiche eseguite dopo il suo inizio, oppure dopo un punto di salvataggio specifico. Non è una macchina del tempo per il database: se hai già eseguito COMMIT, il comando non può semplicemente ricostruire il contenuto precedente.
Una transazione raggruppa più operazioni che devono essere trattate come un’unica unità. In pratica, o vanno a buon fine tutte, oppure nessuna deve restare applicata. È il caso tipico di un trasferimento di denaro, dove il prelievo da un conto e l’accredito su un altro devono rimanere coerenti.
BEGIN;

UPDATE conti
SET saldo = saldo - 100
WHERE id = 1;

UPDATE conti
SET saldo = saldo + 100
WHERE id = 2;

COMMIT;
Se durante il controllo noto un errore, sostituisco COMMIT con ROLLBACK.
BEGIN;

UPDATE conti
SET saldo = saldo - 100
WHERE id = 1;

UPDATE conti
SET saldo = saldo + 100
WHERE id = 99;

ROLLBACK;
In questo caso il saldo del primo conto torna al valore iniziale, perché entrambe le modifiche appartenevano alla stessa transazione. Il comando ha senso soltanto se la connessione mantiene ancora la transazione aperta.
Come usare il rollback in modo sicuro
Il flusso più affidabile è semplice, ma richiede disciplina. Io apro esplicitamente la transazione, verifico con una SELECT ciò che sto per cambiare, eseguo l’operazione e controllo il risultato prima di confermare.
- Avvia la transazione con
BEGINoSTART TRANSACTION. - Esegui una SELECT per identificare con precisione le righe coinvolte.
- Applica INSERT, UPDATE o DELETE usando condizioni specifiche.
- Controlla il numero di righe modificate e il nuovo stato dei dati.
- Usa
COMMITsolo dopo le verifiche, altrimenti eseguiROLLBACK.
START TRANSACTION;

SELECT id, stato
FROM ordini
WHERE id = 458;

UPDATE ordini
SET stato = 'annullato'
WHERE id = 458
  AND stato = 'in lavorazione';

SELECT id, stato
FROM ordini
WHERE id = 458;

ROLLBACK;
Questo esempio è utile per testare una modifica senza lasciarla nel database. La tecnica è particolarmente pratica in produzione quando devo verificare una query rischiosa, ma non sostituisce un backup né una procedura di change management.
Un errore comune consiste nell’eseguire UPDATE e ROLLBACK in due schede diverse dell’editor SQL. Le transazioni appartengono alla sessione o connessione, quindi il secondo comando deve essere inviato dalla stessa connessione che ha eseguito la modifica.
Il problema dell’autocommit
Con l’autocommit attivo, ogni istruzione completata con successo viene confermata automaticamente. In questa modalità, dopo un UPDATE già eseguito non puoi contare su ROLLBACK per annullarlo, perché la transazione è terminata prima che tu possa intervenire.
Per più operazioni collegate, disattiva l’autocommit nella sessione oppure apri una transazione esplicita. La sintassi varia, ma il principio resta uguale: prima si modifica, poi si decide se confermare.
SET autocommit = 0;

START TRANSACTION;

UPDATE prodotti
SET prezzo = prezzo * 1.10
WHERE categoria = 'hardware';

ROLLBACK;
In applicazioni reali, il controllo dell’autocommit può essere gestito dal driver, dall’ORM o dal connection pool. È uno dei motivi per cui una query che sembra corretta in un client può comportarsi diversamente dentro un’applicazione.
Quando serve un SAVEPOINT invece di annullare tutto
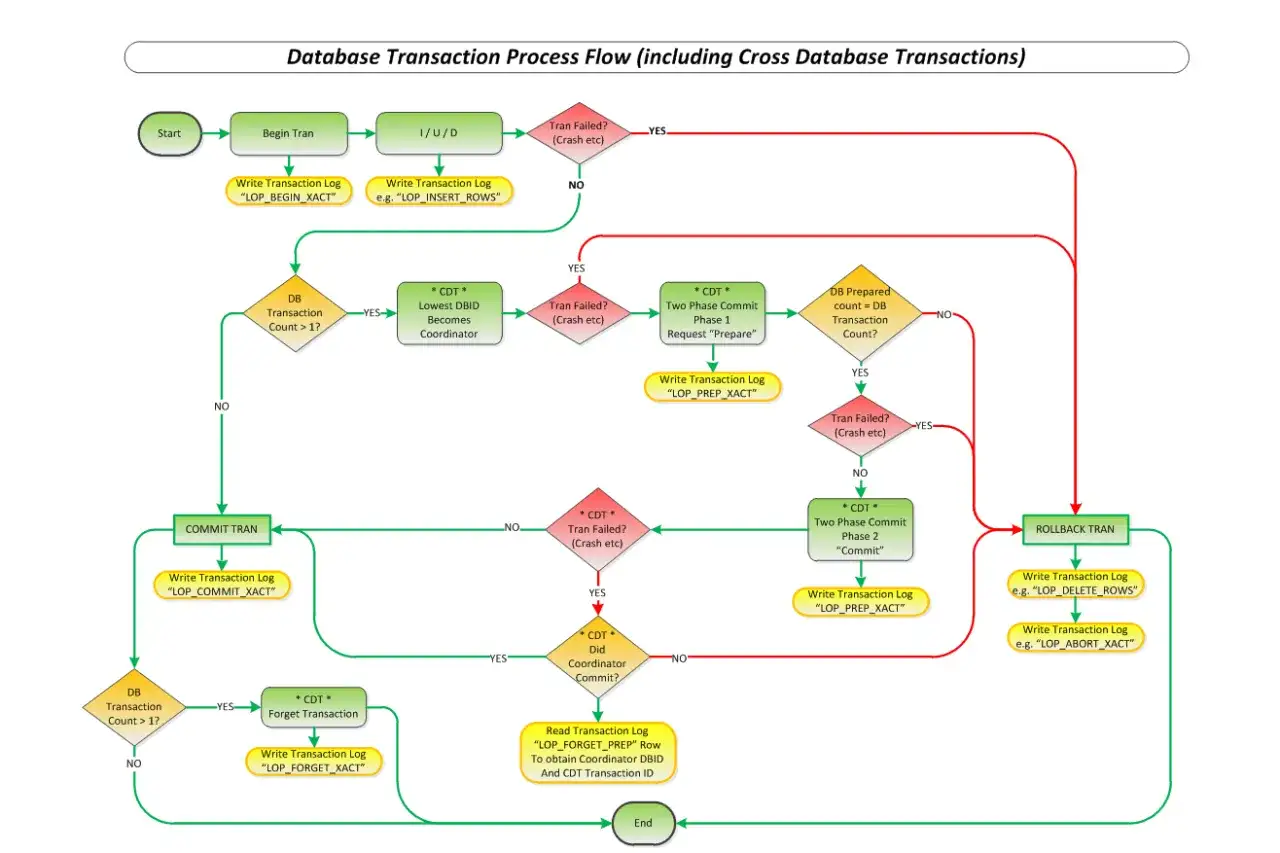
ROLLBACK annulla l’intera transazione, mentre SAVEPOINT crea un punto intermedio al quale tornare. Lo uso quando una procedura contiene più passaggi e voglio conservare quelli già verificati, eliminando solo l’ultima parte.
BEGIN;

INSERT INTO clienti (nome, email)
VALUES ('Luca Bianchi', 'luca@example.it');

SAVEPOINT dopo_cliente;

INSERT INTO ordini (cliente_id, totale)
VALUES (120, 89.90);

ROLLBACK TO SAVEPOINT dopo_cliente;

INSERT INTO ordini (cliente_id, totale)
VALUES (120, 79.90);

COMMIT;
Il primo INSERT resta valido, mentre il secondo viene annullato e sostituito. La differenza è importante perché ROLLBACK TO SAVEPOINT non chiude la transazione: puoi ancora correggere i dati e arrivare al commit finale.
I savepoint sono utili anche nella gestione degli errori. In PostgreSQL, per esempio, una transazione che riceve un errore può entrare in uno stato non più utilizzabile fino a un rollback completo o a un ritorno a un savepoint. In MySQL, invece, i lock sulle righe possono avere comportamenti specifici dopo il ritorno a un punto di salvataggio.
SAVEPOINT verifica;

DELETE FROM righe_ordine
WHERE ordine_id = 458;

SELECT COUNT(*)
FROM righe_ordine
WHERE ordine_id = 458;

ROLLBACK TO SAVEPOINT verifica;

COMMIT;
Il mio consiglio è di dare ai savepoint nomi descrittivi e di usarli nei passaggi realmente reversibili. Moltiplicarli senza criterio rende il flusso difficile da leggere e non risolve i problemi di una transazione progettata male.
Le differenze tra PostgreSQL, MySQL e SQL Server
La logica generale è comune, ma la sintassi e i limiti dipendono dal sistema. Conoscere queste differenze evita di copiare una procedura valida in un database e applicarla alla cieca in un altro.
| Database | Avvio transazione | Rollback parziale | Attenzione principale |
|---|---|---|---|
| PostgreSQL | BEGIN |
ROLLBACK TO SAVEPOINT nome |
Un errore può rendere inutilizzabile la transazione fino al rollback. |
| MySQL | START TRANSACTION |
ROLLBACK TO SAVEPOINT nome |
Il rollback dipende dal motore della tabella, per esempio InnoDB. |
| SQL Server | BEGIN TRANSACTION |
ROLLBACK TRANSACTION nome |
Le transazioni annidate non sono indipendenti come spesso si pensa. |
In MySQL, le operazioni sulle tabelle transazionali InnoDB possono essere annullate, mentre le tabelle non transazionali possono conservare le modifiche anche dopo ROLLBACK. Il controllo del motore della tabella è quindi una verifica preliminare obbligatoria, soprattutto durante una migrazione.
SQL Server supporta transazioni esplicite e savepoint, ma un COMMIT interno non rende autonomamente permanente una transazione annidata. In molti casi è la transazione esterna a determinare il risultato finale, perciò la gestione con TRY/CATCH deve controllare con attenzione lo stato della transazione.
BEGIN TRY
    BEGIN TRANSACTION;

    UPDATE inventario
    SET quantita = quantita - 1
    WHERE prodotto_id = 25
      AND quantita > 0;

    IF @@ROWCOUNT = 0
        THROW 50001, 'Quantità insufficiente', 1;

    COMMIT TRANSACTION;
END TRY
BEGIN CATCH
    IF XACT_STATE() <> 0
        ROLLBACK TRANSACTION;

    THROW;
END CATCH;
In PostgreSQL e MySQL troverai spesso BEGIN o START TRANSACTION, mentre in SQL Server è più comune BEGIN TRANSACTION. Non cambia l’idea di fondo, ma cambia il modo in cui il codice applicativo rileva gli errori e chiude la connessione.
Quando ROLLBACK non basta
Il caso più delicato è una modifica già confermata. Se hai eseguito COMMIT, devi recuperare il dato da un backup, da una replica, dal log delle transazioni o da una procedura di compensazione. In pratica non “riavvolgi” il database: applichi una nuova modifica che ricostruisce lo stato desiderato.
Bisogna inoltre considerare le istruzioni che eseguono un commit implicito o che non partecipano pienamente alle transazioni. Le regole cambiano tra i database e possono riguardare alcune operazioni DDL, come modifiche allo schema, creazione di tabelle o cambiamenti di struttura.
- DELETE senza WHERE può cancellare migliaia di righe prima che tu possa accorgerti dell’errore.
- DDL e commit impliciti possono chiudere la transazione in alcuni sistemi.
- Trigger possono eseguire altre modifiche collegate alla query.
- Chiamate esterne, file e API non vengono annullati da ROLLBACK.
- Transazioni lunghe possono mantenere lock e rallentare gli altri utenti.
Un rollback non cancella gli effetti già inviati a un servizio esterno e non annulla una email spedita da un trigger o da un processo applicativo. Per questo, nei sistemi distribuiti preferisco usare operazioni idempotenti, code e azioni di compensazione, invece di affidarmi all’idea che una singola transazione SQL possa controllare tutto.
Leggi anche: Dizionario Python senza errori - guida a chiavi e metodi
Come recuperare dopo un commit sbagliato
La prima regola è fermare le scritture concorrenti, se possibile, e conservare l’ora esatta dell’incidente. Poi confronto backup, audit log e dati correnti per preparare una query inversa, per esempio reinserendo righe cancellate o ripristinando i valori precedenti.
BEGIN;

UPDATE clienti
SET stato = stato_precedente
WHERE id IN (101, 102, 103);

SELECT id, stato
FROM clienti
WHERE id IN (101, 102, 103);

COMMIT;
Una query di compensazione va testata su una copia del database e deve includere una condizione identificativa precisa. Se non possiedi il valore precedente, il rollback non può inventarlo: servono backup, audit trail o versionamento dei dati.
Una piccola checklist prima di confermare le modifiche
Prima di eseguire COMMIT, controllo sempre che la query abbia coinvolto il numero atteso di righe, che la connessione sia quella giusta e che non ci siano transazioni aperte da troppo tempo. Sono controlli banali, ma nella pratica evitano più incidenti di qualsiasi comando sofisticato.
- Verifica di essere nella base dati corretta.
- Esegui prima una SELECT con lo stesso filtro dell’UPDATE o del DELETE.
- Controlla row count e valori risultanti.
- Usa un savepoint quando la procedura ha più fasi indipendenti.
- Registra chi ha eseguito la modifica e con quale script.
- Conferma solo dopo aver controllato vincoli, trigger e dati correlati.
Per me, ROLLBACK è soprattutto uno strumento di progettazione, non un pulsante di emergenza. Se ogni modifica importante nasce dentro una transazione esplicita, con verifiche e un piano di recupero, il database diventa molto più prevedibile e anche gli errori più fastidiosi restano gestibili.