Quando due utenti scrivono “José” e “Jose”, il database deve sapere se considerarli uguali, come ordinarli e se accettare entrambe le varianti in un campo univoco. La collation SQL stabilisce proprio queste regole, influenzando confronti, ricerche, ordinamenti, indici e importazioni di dati. In questa guida chiarisco cosa significa, dove si configura e come scegliere impostazioni coerenti in MySQL, PostgreSQL e SQL Server.
La collation decide come il database confronta e ordina il testo
- Non è la codifica: charset e collation risolvono problemi diversi.
- Maiuscole e accenti possono essere distinti oppure ignorati.
- Database, tabella e colonna possono avere impostazioni differenti.
- COLLATE consente di applicare una regola solo a una query o a un’espressione.
- Indici e vincoli UNIQUE possono cambiare comportamento quando cambia la collation.
Che cos’è una collation e perché cambia i risultati
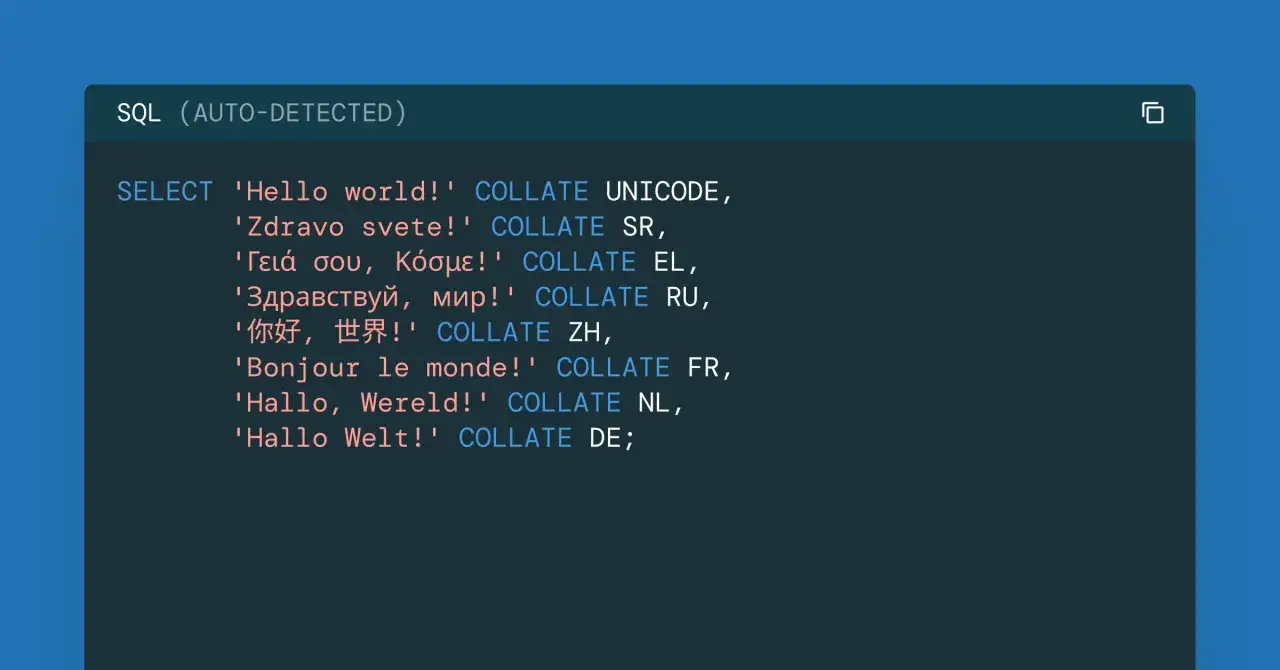
Una collation è l’insieme di regole usato dal database per confrontare stringhe e stabilire il loro ordine. Non dice quali caratteri possono essere memorizzati: quello dipende dal character set, cioè dalla codifica. La collation stabilisce invece come quei caratteri vengono interpretati durante operazioni come =, LIKE, ORDER BY, GROUP BY e UNIQUE.
La differenza si vede subito con maiuscole e accenti. In una collation case-insensitive, “Roma” e “roma” possono risultare uguali. In una collation accent-insensitive, anche “caffè” e “caffe” possono essere trattati come lo stesso testo. Non è una scelta puramente estetica: può determinare se una ricerca trova un risultato oppure no.
SELECT *
FROM utenti
WHERE cognome = 'Rossi';
La query sembra semplice, ma il risultato dipende dalla collation della colonna e dalle regole del motore. Se la colonna è case-sensitive, “Rossi” e “ROSSI” sono valori diversi. Se è case-insensitive, il confronto può considerarli equivalenti senza dover applicare LOWER() al campo.
Io tengo sempre separati i due concetti. UTF-8 risolve la rappresentazione dei caratteri, mentre la collation risolve il loro confronto. Usare una codifica corretta non garantisce automaticamente ordinamenti adatti all’italiano, ricerche senza distinzione tra maiuscole e minuscole o gestione uniforme degli accenti.
Dove si decide la regola di confronto
La collation può essere definita a più livelli. Il comportamento esatto cambia tra i database, ma il principio è simile: un’impostazione generale fornisce un valore predefinito, mentre una regola più specifica può sostituirla.
| Livello | Cosa influenza | Quando usarlo |
|---|---|---|
| Server | Impostazioni predefinite per nuove basi di dati o sessioni | Solo come scelta generale dell’istanza |
| Database | Oggetti creati senza una collation esplicita | Per definire la regola principale di un progetto |
| Tabella | Colonne testuali create successivamente | Per gruppi omogenei di dati |
| Colonna | Confronti, ordinamenti e vincoli su uno specifico campo | Quando nomi, codici e descrizioni hanno esigenze diverse |
| Espressione o query | Una singola operazione SQL | Per eccezioni controllate e confronti temporanei |
In MySQL, per esempio, la collation può essere impostata a livello di server, database, tabella e colonna. La colonna ha la precedenza sul valore ereditato dalla tabella, mentre una clausola applicata direttamente all’espressione può modificare il confronto di quella sola operazione.
Questo sistema è comodo, ma crea facilmente incoerenze. Una tabella migrata da un vecchio progetto può mantenere una collation diversa dal database principale e produrre errori durante join, confronti o importazioni. Per questo controllo sempre la configurazione reale con le viste di sistema, senza fidarmi soltanto dei valori predefiniti dichiarati dal framework.
MySQL, PostgreSQL e SQL Server richiedono scelte diverse
Parlare genericamente di “collation SQL” può trarre in inganno, perché ogni motore usa nomi, livelli e regole proprie. La logica di base è comune, ma la sintassi e il supporto Unicode non sono intercambiabili.
| Motore | Caratteristiche da conoscere | Rischio frequente |
|---|---|---|
| MySQL | Collation legate al character set, con impostazioni a più livelli | Mescolare collation diverse, per esempio durante una migrazione |
| PostgreSQL | Provider libc o ICU, con collations deterministiche o non deterministiche |
Dare per scontato che ogni locale sia disponibile su ogni server |
| SQL Server | Nomi come CI_AS, dove CI indica case-insensitive e AS accent-sensitive |
Conflitti tra colonne o database con code page differenti |
In MySQL 8, una scelta comune per testi Unicode è utf8mb4_0900_ai_ci. La parte ai indica accent-insensitive e ci case-insensitive. È pratica per ricerche anagrafiche e cataloghi, ma non è adatta se “e” ed “è” devono restare distinguibili.
PostgreSQL offre un controllo più articolato grazie a ICU. Una collation può essere definita con CREATE COLLATION e poi applicata a una colonna o a una query. Le collations non deterministiche possono supportare confronti insensibili a maiuscole, accenti o forme Unicode, ma richiedono test accurati e dipendono dalla disponibilità di ICU e dalla versione delle sue regole.
CREATE COLLATION italiano_testo
  (provider = icu, locale = 'it-IT', deterministic = true);

SELECT nome
FROM prodotti
ORDER BY nome COLLATE italiano_testo;
In SQL Server, la sigla rende spesso leggibile la scelta. Latin1_General_100_CI_AI indica una collation insensibile a maiuscole e accenti. Per un confronto puntuale si può usare COLLATE, ma la regola deve essere compatibile con il tipo di dato e con il resto dell’espressione.
Come configurare la collation senza creare problemi
Io seguo un percorso in cinque passaggi. Prima definisco il comportamento richiesto dall’applicazione, poi verifico il supporto del motore, scelgo una collation coerente e solo alla fine la applico agli oggetti. Invertire questo ordine porta spesso a correzioni costose durante la migrazione.
1. Stabilire cosa deve essere uguale
Chiediti se “Milano” e “milano” devono rappresentare la stessa città. Fai lo stesso con accenti, simboli, alfabeti diversi e forme Unicode equivalenti. Il requisito funzionale viene prima del nome della collation, perché sigle apparentemente simili possono avere comportamenti diversi tra motori.
2. Scegliere una configurazione coerente
Per un catalogo prodotti o una rubrica, una collation case-insensitive e spesso accent-insensitive semplifica la ricerca. Per codici, identificativi, token e valori tecnici è più prudente usare confronti sensibili, così “AB12” e “ab12” non vengono confusi.
In MySQL, una nuova tabella può essere definita così:
CREATE TABLE clienti (
  id BIGINT PRIMARY KEY,
  nome VARCHAR(120) NOT NULL,
  email VARCHAR(255) NOT NULL
)
CHARACTER SET utf8mb4
COLLATE utf8mb4_0900_ai_ci;
Per una modifica limitata a una singola query, la clausola SQL COLLATE è più adatta di una conversione generale della tabella. La uso soprattutto quando devo confrontare dati provenienti da fonti diverse o verificare l’effetto di una regola prima di adottarla in modo permanente.
3. Controllare vincoli e indici
Una collation case-insensitive può cambiare il comportamento di un indice UNIQUE. Se il database considera uguali “Luca” e “luca”, il secondo inserimento può essere rifiutato. Prima di cambiare le regole, individuo i duplicati logici che prima erano distinti soltanto per maiuscole o accenti.
4. Testare query reali
Non mi limito a provare una condizione con =. Verifico anche LIKE, ordinamento, raggruppamento, paginazione e join tra tabelle. Una collation può produrre risultati corretti in una ricerca semplice ma ordinare in modo inatteso un elenco o creare conflitti in una query tra colonne diverse.
Leggi anche: API informatiche - come funzionano e quale approccio scegliere
5. Applicare la modifica durante una migrazione controllata
La conversione di una tabella può richiedere tempo, spazio temporaneo e lock. In produzione pianifico una finestra, controllo la dimensione degli indici e preparo un rollback. Una modifica apparentemente innocua può anche alterare l’ordine dei risultati, i piani di esecuzione e i dati accettati dai vincoli.
Gli errori più comuni riguardano confronti e prestazioni
Il primo errore è applicare LOWER() o UPPER() a ogni ricerca senza valutare la collation. La tecnica può funzionare, ma spesso rende più difficile usare un indice ordinario. Se il caso d’uso è stabile, è generalmente più pulito definire la regola direttamente sulla colonna o predisporre un indice compatibile.
Un altro problema nasce dal mescolare collation diverse in un confronto o in un join. MySQL può restituire errori di incompatibilità, mentre SQL Server applica regole di precedenza tra espressioni esplicite, colonne e valori predefiniti. In entrambi i casi, correggere la causa strutturale è preferibile a inserire COLLATE casualmente in ogni query.
Le collation applicate a livello di espressione possono inoltre ridurre l’efficacia degli indici. Non significa che ogni uso di COLLATE sia lento, ma che bisogna controllare il piano di esecuzione. Se una ricerca molto frequente usa una regola diversa da quella dell’indice, il motore potrebbe dover convertire, ordinare o leggere più righe.
Con PostgreSQL considero anche la distinzione tra collation deterministica e non deterministica. Quest’ultima è utile per confronti più flessibili, ma può avere conseguenze su indici, uguaglianze e gestione delle versioni ICU. Dopo un aggiornamento del sistema operativo o delle librerie, rifaccio i test sugli ordinamenti che hanno valore applicativo.
Infine, non confondo la collation con la normalizzazione Unicode. Due stringhe possono rappresentare lo stesso carattere usando sequenze di code point differenti. Se il progetto riceve dati da più sistemi, può essere necessario normalizzare il testo nell’applicazione o durante l’importazione, perché la sola collation non risolve ogni differenza di rappresentazione.
La checklist che uso prima di rendere definitiva una scelta
Prima di chiudere la configurazione, verifico che il character set supporti tutti i caratteri richiesti e che la collation sia disponibile nella versione concreta del database. Controllo anche la compatibilità con driver, ORM, strumenti di migrazione e ambiente di test.
- Definisco se maiuscole e minuscole devono essere equivalenti.
- Decido se gli accenti devono influire sul confronto.
- Uso un character set Unicode adeguato, preferibilmente utf8mb4 in MySQL.
- Controllo duplicati prima di modificare vincoli o indici.
- Provo ricerca, ordinamento, join, raggruppamento e paginazione.
- Confronto i piani di esecuzione prima e dopo la modifica.
La scelta migliore non è quella con il nome più moderno, ma quella che rende prevedibili i dati per gli utenti e per il codice. Una collation uniforme, documentata e testata evita sorprese molto più efficacemente di correzioni distribuite nelle singole query.