Un’applicazione può ricevere configurazioni, attributi variabili o documenti annidati senza adattarsi ogni volta a uno schema rigido. In SQL Server, però, usare JSON bene significa sapere quando conservarlo così com’è, come estrarne i valori e come evitare che le query diventino lente o difficili da mantenere. Qui raccolgo funzioni, esempi T-SQL, tecniche di indicizzazione e criteri pratici per scegliere tra JSON e modello relazionale.
Le decisioni che fanno funzionare davvero il JSON in SQL Server
- JSON_VALUE estrae valori singoli come stringhe, numeri o date.
- JSON_QUERY restituisce oggetti e array ancora in formato JSON.
- OPENJSON trasforma strutture annidate in righe e colonne interrogabili.
- Una colonna calcolata indicizzata accelera le ricerche su proprietà usate spesso.
- Il JSON è utile per dati flessibili, ma non sostituisce sempre un modello relazionale.
Perché usare JSON dentro SQL Server
Il supporto nativo per JSON è disponibile in SQL Server dal 2016 e permette di combinare dati relazionali e documenti semi-strutturati nella stessa tabella. Io lo trovo particolarmente utile quando una parte dei dati cambia spesso, per esempio le caratteristiche tecniche di prodotti, le preferenze di un utente o il payload ricevuto da un’API.
Il vantaggio principale è la flessibilità dello schema. Una tabella può conservare colonne stabili, come identificativo e data di creazione, insieme a un documento JSON con proprietà variabili. Il compromesso è evidente: il database non controlla automaticamente ogni campo interno al documento con la stessa rigidità applicata alle colonne tradizionali.
| Scenario | JSON | Schema relazionale |
|---|---|---|
| Attributi diversi per ogni riga | Molto adatto | Richiede più colonne o tabelle |
| Ricerche frequenti su pochi campi | Possibile con indici mirati | Generalmente più semplice |
| Relazioni tra entità | Scomodo da gestire | Scelta preferibile |
| Integrazione con API | Pratico e naturale | Richiede trasformazioni |
Le versioni più recenti aggiungono anche un tipo JSON nativo, disponibile negli ambienti che supportano SQL Server 2025 e il ramo 17.x. In molti progetti esistenti, tuttavia, troverai ancora colonne nvarchar(max): le funzioni principali lavorano con entrambe le modalità, quindi la strategia applicativa resta in gran parte la stessa.
Come salvare e validare un documento JSON
Per iniziare non serve una struttura complicata. Una soluzione comune consiste nel mantenere una chiave primaria, alcune colonne relazionali e il documento in una colonna testuale. Io aggiungo quasi sempre un vincolo con ISJSON, perché impedisce di ritrovarsi con stringhe non valide che falliranno solo al momento della lettura.
CREATE TABLE dbo.OrdiniApi
(
    Id INT IDENTITY(1,1) PRIMARY KEY,
    ClienteId INT NOT NULL,
    CreatoIl DATETIME2 NOT NULL DEFAULT SYSUTCDATETIME(),
    Payload NVARCHAR(MAX) NOT NULL,
    CONSTRAINT CK_OrdiniApi_PayloadJson
        CHECK (ISJSON(Payload) = 1)
);
Un documento di esempio può contenere dati semplici e strutture annidate nello stesso oggetto.
{
  "numero": "ORD-1048",
  "stato": "spedito",
  "totale": 149.90,
  "cliente": {
    "email": "cliente@example.it",
    "cap": "20100"
  },
  "righe": [
    { "sku": "KB-01", "quantita": 1 },
    { "sku": "MS-04", "quantita": 2 }
  ]
}
Il vincolo garantisce soltanto che il testo sia JSON valido. Non controlla che esistano proprietà come stato o totale, né che abbiano il tipo atteso. Per questo, nei flussi importanti verifico anche la presenza dei campi obbligatori con JSON_PATH_EXISTS o con controlli applicativi prima dell’inserimento.
SELECT Id, ClienteId
FROM dbo.OrdiniApi
WHERE ISJSON(Payload) = 1
  AND JSON_VALUE(Payload, '$.stato') IS NOT NULL;
Questo piccolo controllo fa una grande differenza nei sistemi che ricevono dati da servizi esterni. Un payload valido dal punto di vista sintattico può comunque essere inutilizzabile per la logica dell’applicazione.
Le funzioni T-SQL da conoscere per leggere il JSON
Le quattro funzioni più importanti coprono casi diversi. Il mio consiglio è non scegliere in base al nome, ma al tipo di risultato che vuoi ottenere.
| Funzione | Restituisce | Uso tipico |
|---|---|---|
ISJSON |
Un controllo di validità | Filtrare o rifiutare documenti non validi |
JSON_VALUE |
Un valore scalare | Stato, codice, importo o data |
JSON_QUERY |
Un oggetto o un array | Restituire una sezione JSON completa |
OPENJSON |
Righe e colonne | Analizzare array e dati annidati |
JSON_MODIFY |
Il documento aggiornato | Modificare una proprietà senza ricostruire tutto |
Estrarre valori singoli con JSON_VALUE
Per leggere proprietà scalari uso JSON_VALUE. Il percorso inizia con $, che rappresenta il documento, seguito dai nomi delle proprietà.
SELECT
    Id,
    JSON_VALUE(Payload, '$.numero') AS NumeroOrdine,
    JSON_VALUE(Payload, '$.stato') AS Stato,
    JSON_VALUE(Payload, '$.cliente.cap') AS CAP
FROM dbo.OrdiniApi
WHERE JSON_VALUE(Payload, '$.stato') = N'spedito';
La stessa espressione può comparire in WHERE, ORDER BY e GROUP BY. Faccio però attenzione ai numeri: il valore estratto è spesso trattato come testo, quindi per confronti numerici espliciti conviene usare CAST o una colonna calcolata tipizzata.
SELECT Id, Payload
FROM dbo.OrdiniApi
WHERE TRY_CONVERT(decimal(10,2), JSON_VALUE(Payload, '$.totale')) > 100.00;
Restituire array e oggetti con JSON_QUERY
JSON_QUERY serve quando il risultato non è un singolo valore ma un oggetto o un array. Usare JSON_VALUE su $.cliente o $.righe porterebbe a un risultato nullo o non adatto allo scopo.
SELECT
    JSON_QUERY(Payload, '$.cliente') AS DatiCliente,
    JSON_QUERY(Payload, '$.righe') AS RigheOrdine
FROM dbo.OrdiniApi;
Trasformare un array in righe con OPENJSON
Quando devo fare report, somme o join, preferisco trasformare l’array in un set di righe. OPENJSON funziona come una vista tabellare sul documento e si combina bene con CROSS APPLY.
SELECT
    o.Id,
    r.Sku,
    r.Quantita
FROM dbo.OrdiniApi AS o
CROSS APPLY OPENJSON(o.Payload, '$.righe')
WITH
(
    Sku NVARCHAR(50) '$.sku',
    Quantita INT '$.quantita'
) AS r;
Un ordine con tre elementi produrrà tre righe nel risultato. È il passaggio più importante quando un documento ricevuto da un’API deve entrare in una procedura di analisi relazionale.
Come importare, aggiornare e generare JSON
Non si usa JSON in SQL Server soltanto per leggere dati già presenti. Lo stesso motore può importare documenti, modificarne alcune proprietà e produrre JSON per un’applicazione o un servizio esterno.
Aggiornare una proprietà
JSON_MODIFY restituisce una nuova versione del documento con il percorso indicato aggiornato. La funzione non modifica la riga da sola, quindi va inserita in un’istruzione UPDATE.
UPDATE dbo.OrdiniApi
SET Payload = JSON_MODIFY(Payload, '$.stato', N'consegnato')
WHERE Id = 12;
Per aggiornare più valori nella stessa operazione è possibile concatenare le chiamate, ma non esagero con questa tecnica. Se una riga viene modificata continuamente e il documento è molto grande, il costo di riscrittura può diventare più rilevante rispetto a quello di una colonna relazionale dedicata.
Caricare JSON in una tabella
Per importare un array ricevuto da un servizio, definisco esplicitamente nomi e tipi nella clausola WITH. Questo rende il caricamento più prevedibile e limita le conversioni implicite.
DECLARE @Documento NVARCHAR(MAX) = N'{
  "prodotti": [
    { "codice": "A10", "prezzo": 12.50 },
    { "codice": "B20", "prezzo": 18.90 }
  ]
}';

SELECT Codice, Prezzo
FROM OPENJSON(@Documento, '$.prodotti')
WITH
(
    Codice NVARCHAR(30) '$.codice',
    Prezzo DECIMAL(10,2) '$.prezzo'
);
Se una proprietà contiene a sua volta un oggetto o un array che vuoi conservare interamente, aggiungi AS JSON. Senza quella parola chiave, SQL Server prova a restituire un valore scalare.
Generare JSON per API e applicazioni
Per restituire righe come documento JSON uso generalmente FOR JSON PATH, perché permette di controllare meglio la forma dell’output.
SELECT
    Id AS id,
    ClienteId AS clienteId,
    JSON_VALUE(Payload, '$.stato') AS stato
FROM dbo.OrdiniApi
WHERE ClienteId = 25
FOR JSON PATH;
In questo modo SQL Server può fungere da punto di trasformazione tra il modello interno del database e il formato richiesto da un’API. La separazione è utile, perché evita di obbligare le tabelle a seguire esattamente il contratto JSON esposto all’esterno.
Come migliorare le prestazioni delle query JSON
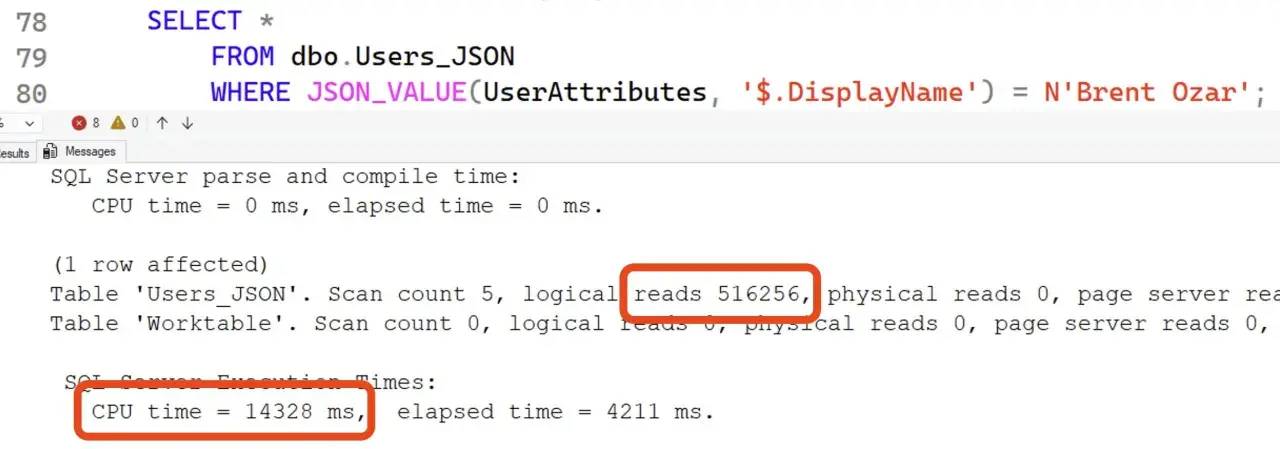
Il primo errore che vedo nei progetti è salvare tutto in JSON e poi filtrare migliaia di righe con JSON_VALUE senza alcun indice. Funziona nei test con pochi record, ma può trasformarsi in una scansione completa della tabella quando il volume cresce.
Indicizzare una proprietà usata spesso
Una strategia compatibile con molte versioni consiste nell’aggiungere una colonna calcolata e indicizzarla. È importante usare la stessa espressione nelle query e convertire i valori numerici al tipo corretto.
ALTER TABLE dbo.OrdiniApi
ADD Stato AS JSON_VALUE(Payload, '$.stato');

CREATE INDEX IX_OrdiniApi_Stato
ON dbo.OrdiniApi(Stato);
Per un importo o una quantità preferisco una colonna calcolata tipizzata. Così evito che il database confronti numeri come stringhe e posso ottenere piani più prevedibili.
ALTER TABLE dbo.OrdiniApi
ADD TotaleNumerico AS
    TRY_CONVERT(decimal(10,2), JSON_VALUE(Payload, '$.totale'));

CREATE INDEX IX_OrdiniApi_TotaleNumerico
ON dbo.OrdiniApi(TotaleNumerico);
In SQL Server 2025 e negli ambienti compatibili con il tipo JSON nativo è disponibile anche un JSON index dedicato. È interessante quando si interrogano molti percorsi dentro documenti JSON, ma non elimina la necessità di progettare le query: un indice non può compensare documenti incoerenti o filtri poco selettivi.
Leggi anche: Ciclo for in Python - guida a range, enumerate, zip e SQLite
Quando un indice non basta
Un indice aiuta se cerchi spesso una proprietà precisa, come stato o codice cliente. Non risolve invece il problema di un documento enorme, di array profondamente annidati o di query che estraggono decine di campi per ogni riga.
- Porta nelle colonne normali i dati usati in ogni richiesta.
- Conserva nel JSON gli attributi variabili o raramente interrogati.
- Evita di applicare funzioni a colonne non necessarie nel filtro.
- Misura il piano di esecuzione prima e dopo l’indicizzazione.
Il mio criterio è semplice: indicizzo ciò che filtro spesso e normalizzo ciò che uso per join, vincoli, aggregazioni o ordinamenti frequenti.
Quando scegliere JSON e quando evitarlo
JSON è una buona scelta per metadati, configurazioni, payload di integrazione e attributi che cambiano tra un record e l’altro. È meno adatto quando il dato ha relazioni chiare, regole di integrità o un ruolo centrale nei report aziendali.
| Usa JSON quando | Preferisci tabelle relazionali quando |
|---|---|
| Lo schema varia spesso | Le colonne sono stabili e note |
| Ricevi documenti da API | Devi garantire foreign key e vincoli |
| Conservi configurazioni o metadati | Fai aggregazioni frequenti |
| Leggi il documento quasi sempre interamente | Ricerchi spesso molti campi diversi |
Un errore comune è usare JSON per nascondere un modello dati ancora poco definito. La flessibilità iniziale può diventare debito tecnico: validazione distribuita nell’applicazione, query più verbose e difficoltà nel capire quali proprietà siano davvero affidabili.
Per questo adotterei un modello ibrido nella maggior parte dei casi. Colonne relazionali per identità, stato e date, documento JSON per gli attributi estensibili. È una soluzione meno ideologica e, nella pratica, più facile da far evolvere.
La regola pratica per progettare una soluzione sostenibile
Prima di inserire JSON in una tabella, elenco le proprietà che dovranno essere filtrate, ordinate o collegate ad altre entità. Quelle informazioni meritano quasi sempre una colonna normale o almeno una colonna calcolata indicizzata.
Per il resto, definisco un contratto minimo del documento, valido il contenuto in ingresso e testo query con dati realistici. JSON in SQL Server funziona bene quando aggiunge flessibilità senza diventare il modello dati di tutto il sistema.
Se il carico cresce, controllo i piani di esecuzione, la dimensione media dei documenti e la frequenza degli aggiornamenti. Sono questi tre fattori, più della semplice presenza del JSON, a determinare se la soluzione resterà veloce e manutenibile.