Un progetto di intelligenza artificiale può iniziare con poche righe di Python, ma ottenere risultati affidabili richiede molto più della scelta di una libreria. In questo articolo mostro come usare Python per machine learning e deep learning, quali strumenti scegliere, come collegare i modelli ai database e quali errori evitare quando si passa dal prototipo a un’applicazione reale.
Il percorso più efficace parte dai dati e arriva al modello
- Python è la scelta più pratica perché unisce analisi dei dati, machine learning e sviluppo applicativo.
- Scikit-learn è ideale per classificazione, regressione, clustering e primi prototipi.
- PyTorch, TensorFlow e Keras diventano più adatti per reti neurali e deep learning.
- La qualità del risultato dipende soprattutto da dati, validazione e monitoraggio, non solo dall’algoritmo.
- Per lavorare in produzione servono anche database, API, sicurezza e controllo dei costi.
Perché Python è così usato nell’intelligenza artificiale
Il vantaggio principale di Python non è la velocità di esecuzione pura, ma la possibilità di costruire rapidamente un flusso completo. Posso leggere dati da un database, pulirli, addestrare un modello, valutarlo e pubblicarlo dietro un’API usando strumenti che parlano tra loro in modo coerente.
La sintassi relativamente semplice riduce il tempo dedicato al codice ripetitivo e lascia più spazio alle decisioni importanti. In pratica, mi concentro su quali dati usare, quale metrica scegliere e come verificare che il modello non stia imparando soltanto rumore.
L’ecosistema è un altro punto forte. NumPy gestisce calcoli numerici e array, Pandas lavora con tabelle e serie temporali, Matplotlib e Seaborn aiutano a visualizzare i dati, mentre librerie specializzate coprono il machine learning tradizionale, il deep learning e l’elaborazione del linguaggio naturale.
Questo non significa che Python sia sempre la soluzione migliore. Per l’inferenza su dispositivi con risorse molto limitate o per componenti che richiedono latenza estremamente bassa, può essere utile spostare una parte del codice verso C++, Rust o sistemi ottimizzati. Nella maggior parte dei progetti aziendali, però, Python resta il punto di partenza più produttivo.
Le librerie da scegliere in base al progetto
La scelta dello strumento dovrebbe seguire il problema, non la popolarità del framework. Per un modello che prevede vendite, rileva frodi o assegna un punteggio a un cliente, spesso basta una soluzione di machine learning classico ben preparata.
| Strumento | Uso principale | Quando conviene |
|---|---|---|
| NumPy | Calcolo numerico e matrici | Quando servono operazioni veloci su array e vettori |
| Pandas | Preparazione e analisi dei dati | Per CSV, tabelle SQL, serie temporali e dati aziendali |
| Scikit-learn | Machine learning supervisionato e non supervisionato | Per classificazione, regressione, clustering e pipeline |
| PyTorch | Deep learning e reti neurali | Per computer vision, NLP, modelli personalizzati e GPU |
| TensorFlow e Keras | Modelli neurali e deployment | Quando servono strumenti strutturati per addestramento e distribuzione |
| Transformers | Modelli linguistici e multimodali | Per testo, classificazione semantica, riassunti e chatbot |
Per cominciare, io sceglierei Scikit-learn se i dati sono tabellari e il problema è ben definito. Offre preprocessing, selezione del modello, validazione e metriche in un’unica interfaccia, quindi evita di costruire manualmente troppi passaggi fragili.
PyTorch e TensorFlow hanno più senso quando entrano in gioco immagini, audio, testo non strutturato o reti neurali profonde. Richiedono però più memoria, più tempo di addestramento e una maggiore attenzione alla gestione delle GPU. Usarli su un piccolo dataset tabellare spesso complica il progetto senza migliorare davvero il risultato.
Come costruire un progetto AI con Python
Un flusso solido parte sempre dalla definizione del risultato. Prima di scrivere il modello, chiarisco se voglio prevedere un valore numerico, assegnare una categoria, individuare gruppi o generare contenuti. Questa distinzione determina i dati necessari e le metriche con cui giudicare il sistema.
Preparare dati affidabili
I dati arrivano spesso da database relazionali, file CSV, API o sistemi di log. Prima dell’addestramento bisogna controllare valori mancanti, duplicati, formati incoerenti e colonne che contengono informazioni disponibili solo dopo l’evento da prevedere. Quest’ultimo errore, chiamato data leakage, può produrre risultati eccellenti nei test e inutili nella realtà.
Un dataset piccolo ma coerente è spesso più utile di milioni di righe sporche. Registro sempre la provenienza dei dati, il periodo di raccolta e le trasformazioni applicate, così posso ricostruire il percorso del modello quando qualcosa cambia.
Separare addestramento e verifica
Divido i dati in almeno tre parti quando il progetto lo richiede: addestramento, validazione e test. Il modello vede i dati di training, viene regolato sulla validation e affronta il test finale una sola volta. Per dataset ridotti, la cross-validation aiuta a stimare meglio la stabilità del risultato.
La metrica dipende dal rischio. In un sistema antifrode potrei preferire il recall, cioè la capacità di trovare più casi sospetti, anche accettando qualche falso positivo. In una classificazione medica o finanziaria, invece, precision, recall, F1-score e matrice di confusione vanno letti insieme, mai isolatamente.
Leggi anche: Dizionario Python senza errori - guida a chiavi e metodi
Creare una pipeline ripetibile
Una pipeline riunisce trasformazioni e modello in un unico oggetto. In questo modo normalizzazione, selezione delle colonne e addestramento vengono applicati nello stesso ordine sia ai dati storici sia a quelli nuovi. È una protezione semplice ma decisiva contro differenze invisibili tra ambiente di sviluppo e produzione.
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

modello = Pipeline([
    ("scaler", StandardScaler()),
    ("classifier", LogisticRegression(max_iter=1000))
])

modello.fit(X_train, y_train)
previsioni = modello.predict(X_test)

print(classification_report(y_test, previsioni))
Questo esempio è volutamente essenziale, ma contiene una buona abitudine. La trasformazione e l’algoritmo vengono trattati come un unico processo, mentre il parametro random_state rende l’esperimento più facilmente riproducibile.
Un esempio concreto tra classificazione e previsione
Immaginiamo di voler prevedere se un cliente rinnoverà un abbonamento. Le variabili potrebbero includere numero di accessi, durata dell’abbonamento, ticket aperti, piano scelto e giorni dall’ultimo utilizzo. L’obiettivo non è “usare l’intelligenza artificiale” in astratto, ma stimare una probabilità che aiuti il team commerciale a decidere dove intervenire.
Per un primo modello sceglierei regressione logistica, random forest o gradient boosting. Sono algoritmi adatti ai dati tabellari e, con tecniche di interpretabilità, possono spiegare quali variabili hanno influenzato maggiormente la previsione. Questa trasparenza è spesso più utile di qualche punto percentuale in più ottenuto con una rete neurale difficile da controllare.
Un caso diverso è la classificazione automatica delle richieste al supporto. Qui il testo può essere trasformato in vettori numerici con tecniche di rappresentazione linguistica e poi classificato per categoria. Se il volume è contenuto, un modello leggero è spesso sufficiente; se servono comprensione semantica, multilinguismo o gestione di documenti lunghi, entrano in gioco modelli transformer.
Per le immagini, invece, una rete convoluzionale o un modello preaddestrato può riconoscere difetti, oggetti o anomalie. Il riuso di un modello già addestrato riduce il fabbisogno di dati, ma non elimina la necessità di verificare la qualità delle immagini e la somiglianza tra il dataset originale e quello reale.
Come collegare Python ai database e ai servizi cloud
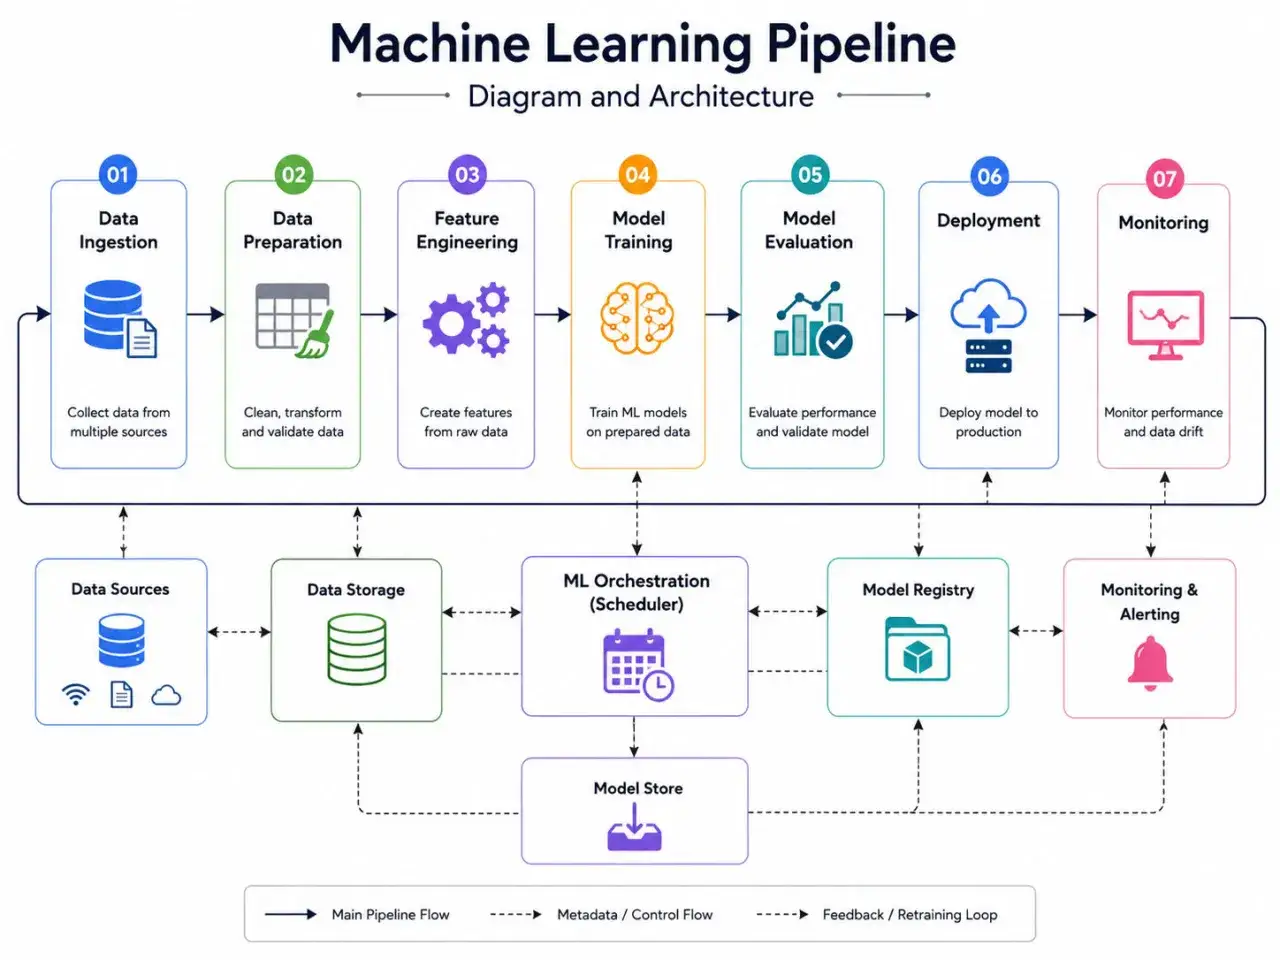
In un progetto reale, il modello non vive dentro un notebook. Legge dati da una fonte, restituisce una previsione e spesso salva l’esito in un database. Per questo considero l’integrazione dati una parte del progetto AI, non un dettaglio da affrontare alla fine.
Con database SQL, Python può usare connettori specifici oppure strumenti come SQLAlchemy. Pandas è comodo per analisi e prototipi, ma non dovrebbe essere usato per caricare indiscriminatamente milioni di righe in memoria. Meglio lavorare con query mirate, paginazione e caricamento a blocchi.
Un’architettura tipica può prevedere PostgreSQL o MySQL per i dati strutturati, un archivio di oggetti per file e modelli, e una coda per le elaborazioni asincrone. Se l’applicazione deve cercare documenti in base al significato, un indice vettoriale può affiancare il database tradizionale. Non sostituisce automaticamente SQL: i due sistemi rispondono a domande diverse.
Nel cloud, il costo dipende soprattutto da frequenza delle predizioni, durata dell’addestramento e uso della GPU. Per un prototipo leggero possono bastare un computer locale o una macchina virtuale economica; un addestramento continuo su GPU può arrivare a decine o centinaia di euro al mese. Prima di scegliere l’infrastruttura, misuro il carico reale e imposto limiti di spesa.
Per esporre il modello uso spesso un’API con FastAPI o un servizio equivalente. L’endpoint riceve dati validati, richiama il modello, registra versione e tempo di risposta, quindi restituisce il risultato. Questo permette di separare il modello dall’interfaccia e di sostituirlo senza riscrivere tutta l’applicazione.
Gli errori che rendono fragile un progetto di intelligenza artificiale
Il primo errore è confondere accuratezza con utilità. Un modello può raggiungere il 95% di accuracy su un dataset sbilanciato limitandosi a prevedere sempre la classe più numerosa. Controllo quindi la distribuzione delle classi e confronto il risultato con una baseline semplice, cioè un metodo di riferimento che il modello deve superare davvero.
Un altro problema frequente è addestrare il modello una volta e dimenticarlo. I comportamenti degli utenti cambiano, i prezzi vengono aggiornati, le campagne modificano i dati e le fonti possono interrompersi. Servono monitoraggio, controllo della distribuzione degli input e una procedura per riaddestrare il modello quando le prestazioni calano.
La riproducibilità conta quanto il codice. Versiono dataset, dipendenze, parametri e modello esportato, evitando di affidarmi a un singolo notebook sul computer personale. Anche un progetto piccolo dovrebbe poter essere eseguito di nuovo da un collega con risultati comprensibili.
Infine, non inserisco dati sensibili senza una valutazione preventiva. Dati personali, informazioni sanitarie e documenti aziendali richiedono minimizzazione, controllo degli accessi, cifratura e regole chiare sulla conservazione. La sicurezza non si aggiunge dopo il modello, perché una previsione corretta ottenuta con dati gestiti male resta un problema.
Il primo progetto utile da realizzare con Python
Per imparare davvero, consiglio un progetto piccolo ma completo, come prevedere una categoria, stimare una domanda o classificare ticket di assistenza. Il dataset dovrebbe avere una dimensione gestibile, un obiettivo misurabile e una fonte che si possa aggiornare senza lavoro manuale.
Partirei da Pandas e Scikit-learn, costruirei una pipeline riproducibile e confronterei almeno tre modelli semplici. Solo dopo aver verificato dati, metriche e costi passerei a PyTorch, a un modello linguistico o a un’infrastruttura cloud più complessa.
Il punto decisivo non è scrivere più codice, ma creare un collegamento affidabile tra dati, decisione e verifica del risultato. È qui che Python dà il meglio: rende rapido il primo esperimento, ma lascia anche gli strumenti necessari per trasformarlo in un servizio concreto.