Quando un database entra nello stato Recovery Pending in SQL Server, l’errore non è quasi mai “solo” un problema del database: spesso il motore non riesce ad accedere a un file, a una risorsa di archiviazione o al transaction log. In questa guida spiego come interpretare il cosiddetto recovery pending SQL Server, quali controlli eseguire per primi e quando conviene ripristinare un backup invece di tentare una riparazione rischiosa.
La sequenza corretta riduce il rischio di perdere dati
- Controlla l’ERRORLOG prima di modificare lo stato del database.
- Verifica file, spazio e permessi dell’account che esegue il servizio SQL Server.
- Preferisci il restore da backup alla riparazione manuale quando esiste una copia valida.
- DBCC CHECKDB con REPAIR_ALLOW_DATA_LOSS va usato solo come ultima risorsa.
- In un ambiente Always On o con TDE, servono controlli specifici prima di intervenire.
Che cosa significa davvero Recovery Pending
SQL Server usa il processo di recovery per riportare il database in uno stato coerente dopo un riavvio, un arresto improvviso o un problema di sistema. Se il motore capisce che deve eseguire il recupero ma non riesce nemmeno ad avviarlo, assegna al database lo stato RECOVERY_PENDING. Non significa automaticamente che tutti i dati siano corrotti.
Nella mia esperienza, la differenza più importante è tra un problema di accesso alle risorse e una vera corruzione logica o fisica. Un file MDF o LDF spostato, un volume non montato, un disco pieno o un permesso mancante possono produrre lo stesso stato di un guasto più grave.
| Stato | Che cosa indica | Prima azione |
|---|---|---|
| ONLINE | Il database è disponibile normalmente. | Nessun intervento urgente. |
| RECOVERING | SQL Server sta applicando il transaction log. | Controllare l’ERRORLOG e attendere se ci sono progressi. |
| RECOVERY_PENDING | Il recovery non riesce a partire per un problema di risorse o accesso. | Individuare la causa prima di forzare operazioni. |
| SUSPECT | Il recovery è fallito e il database non può essere aperto normalmente. | Valutare restore, diagnosi della corruzione e piano di emergenza. |
Per vedere lo stato reale dei database uso una query semplice, evitando di affidarmi soltanto a SQL Server Management Studio:
SELECT
    name,
    state_desc,
    recovery_model_desc,
    user_access_desc
FROM sys.databases
ORDER BY name;
Da dove iniziare senza peggiorare il problema
Il primo controllo è il SQL Server ERRORLOG. La riga che spiega il motivo del blocco spesso compare pochi secondi prima dello stato Recovery Pending e può indicare un errore di I/O, un file inesistente, un log non accessibile oppure un problema di autorizzazioni.
EXEC sys.sp_readerrorlog 0, 1, N'failed';
EXEC sys.sp_readerrorlog 0, 1, N'error';
EXEC sys.sp_readerrorlog 0, 1, N'recovery';
Non limitarti all’ultimo log. Dopo un riavvio, l’informazione decisiva può trovarsi nel file precedente. Controllerei anche il Visualizzatore eventi di Windows, soprattutto se l’ERRORLOG segnala persistent I/O error, timeout del disco o problemi del controller.
Controlla il percorso dei file
Per capire dove SQL Server cerca MDF, NDF e LDF, esegui:
SELECT
    DB_NAME(database_id) AS database_name,
    type_desc,
    physical_name,
    state_desc
FROM sys.master_files
WHERE DB_NAME(database_id) = N'NomeDatabase';
Verifica che ogni percorso esista davvero sul server, che il volume sia montato e che la lettera dell’unità non sia cambiata. In ambienti virtuali o cloud, un disco scollegato o non ancora disponibile dopo il riavvio è una causa meno rara di quanto si pensi.
Controlla spazio e autorizzazioni
Un volume senza spazio libero può impedire l’apertura o l’espansione del transaction log. Cerca di mantenere un margine operativo reale, non appena pochi megabyte, soprattutto per database con attività intensa. L’account del servizio SQL Server deve inoltre avere accesso ai file e alle cartelle che li contengono.
Se i file sono stati copiati, ripristinati o spostati manualmente, ereditarne i permessi non è garantito. Questo è uno dei casi in cui un controllo sul server Windows risolve il problema più velocemente di una lunga serie di comandi T-SQL.
Le cause più frequenti e l’intervento adatto
Lo stesso stato può nascere da situazioni molto diverse. Per questo non considero una procedura di “fix” universale affidabile: prima collego il messaggio dell’ERRORLOG alla causa concreta.
| Possibile causa | Indizio tipico | Intervento prudente |
|---|---|---|
| File MDF o LDF mancanti | SQL Server segnala che il percorso non esiste o il file non può essere aperto. | Ripristinare il volume o il file corretto, senza creare un log vuoto. |
| Permessi insufficienti | Errore di accesso negato dopo uno spostamento o una migrazione. | Correggere i permessi dell’account del servizio. |
| Spazio esaurito | Il volume dati o log è pieno. | Liberare spazio in modo controllato e verificare la crescita dei file. |
| Problema di storage | Errori I/O, timeout o pagine illeggibili nel log. | Risolvere prima il guasto dell’infrastruttura e usare un backup. |
| Transaction log danneggiato | Il recovery fallisce durante la lettura o l’applicazione delle transazioni. | Ripristinare la catena di backup o valutare un recupero d’emergenza. |
| TDE o provider EKM non disponibili | Il database cifrato non riesce ad accedere alle chiavi. | Ripristinare la disponibilità del certificato o del provider di chiavi. |
Un errore comune consiste nel cancellare il file LDF pensando che SQL Server possa ricrearlo senza conseguenze. Non è una procedura di recupero: può eliminare informazioni necessarie al recovery e rendere più difficile il ripristino.
Quando il restore è la scelta corretta
Se hai un backup completo integro e una catena dei log disponibile, il restore è quasi sempre più sicuro di una riparazione. L’obiettivo dovrebbe essere tornare a un punto coerente, rispettando il Recovery Point Objective, non semplicemente riportare il database online a qualsiasi costo.
In un modello di recupero completo, la sequenza tipica è il backup completo, gli eventuali differential backup e tutti i transaction log successivi. L’ultimo restore viene eseguito con WITH RECOVERY per rendere il database operativo.
RESTORE DATABASE [NomeDatabase]
FROM DISK = N'D:\Backup\NomeDatabase_full.bak'
WITH NORECOVERY, REPLACE;

RESTORE LOG [NomeDatabase]
FROM DISK = N'D:\Backup\NomeDatabase_log.trn'
WITH RECOVERY;
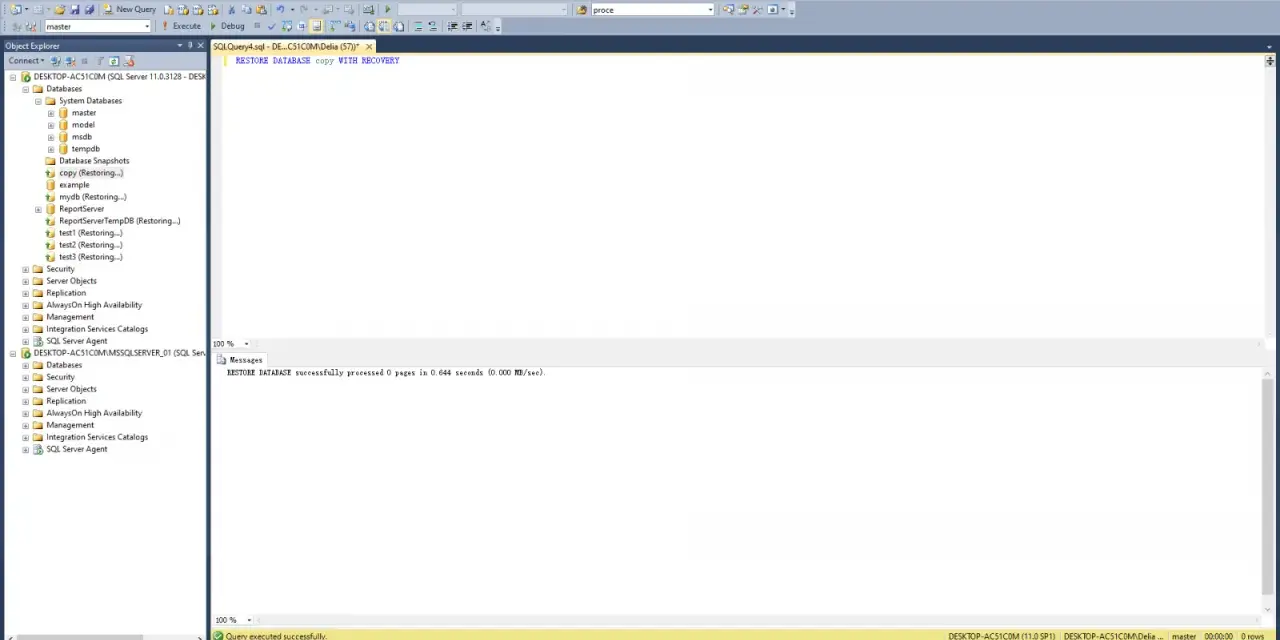
WITH RECOVERY non risolve automaticamente RECOVERY_PENDING. Serve quando il database è già in stato RESTORING e deve terminare una sequenza di ripristino. Confondere i due stati porta spesso a eseguire il comando giusto nel contesto sbagliato.
Leggi anche: Comandi DBCC SQL Server per controlli e manutenzione sicura
Casi particolari con Always On
Se il database appartiene a un availability group, evita di applicare subito la procedura Emergency Mode o una riparazione DBCC sulla replica secondaria. Qui bisogna controllare sincronizzazione, ruolo della replica, endpoint e stato del gruppo, perché un comando locale può peggiorare la configurazione.
In caso di database secondario irrimediabilmente fuori sincronia, la strada più pulita è spesso rimuovere la replica interessata dalla procedura prevista, ripristinare una base coerente e risincronizzarla. La scelta dipende dal ruolo della replica e dagli obiettivi di continuità operativa.
Emergency mode e DBCC CHECKDB come ultima risorsa
Quando non esiste un backup utilizzabile o il restore non è praticabile, puoi tentare una diagnosi in modalità di emergenza. Prima di farlo, conserva una copia dei file originali e documenta ogni comando. La modalità Emergency non ripara il database: permette a SQL Server di eseguire controlli speciali su un database non accessibile normalmente.
ALTER DATABASE [NomeDatabase] SET EMERGENCY;
ALTER DATABASE [NomeDatabase] SET SINGLE_USER WITH ROLLBACK IMMEDIATE;

DBCC CHECKDB ([NomeDatabase])
WITH NO_INFOMSGS, ALL_ERRORMSGS;
Leggi l’output completo di DBCC CHECKDB. Se segnala corruzione, la prima scelta resta il ripristino da backup. L’opzione seguente è da considerare soltanto quando accetti una possibile perdita di dati:
DBCC CHECKDB ([NomeDatabase], REPAIR_ALLOW_DATA_LOSS)
WITH NO_INFOMSGS, ALL_ERRORMSGS;
Il nome è esplicito: REPAIR_ALLOW_DATA_LOSS può eliminare pagine, righe o strutture corrotte per rendere il database nuovamente utilizzabile. Non è equivalente a un restore e non garantisce che l’applicazione continui a funzionare correttamente.
Dopo una riparazione, eseguo nuovamente CHECKDB, controllo le tabelle più importanti e confronto i dati con le fonti applicative. Solo quando il database è stato verificato ha senso riportarlo a multi-user:
ALTER DATABASE [NomeDatabase] SET MULTI_USER;Se il database resta bloccato, se il log contiene errori I/O persistenti o se CHECKDB segnala danni estesi, fermerei i tentativi casuali e coinvolgerei un professionista del recupero dati. Ogni nuova scrittura può ridurre le possibilità di ottenere un recupero completo.
Come prevenire un nuovo Recovery Pending
La prevenzione si basa meno su comandi di emergenza e più sulla qualità dell’operatività quotidiana. Verifico regolarmente backup, spazio libero, crescita dei file, salute dello storage e presenza dei messaggi critici nei log.
- Esegui backup completi secondo un calendario definito e prova davvero il restore.
- Se usi il modello Full, pianifica i backup del transaction log e controlla che la catena sia continua.
- Monitora spazio libero e latenza dei volumi che ospitano MDF, NDF e LDF.
- Evita spostamenti manuali dei file senza aggiornare correttamente la configurazione del database.
- Documenta account del servizio, permessi, certificati TDE e dipendenze da provider esterni.
- Configura alert per errori di I/O, database sospetti e fallimenti dei job di backup.
Il test più utile non è sapere che il backup è stato creato, ma verificare che sia possibile ripristinarlo entro il tempo richiesto dall’azienda. Un backup mai testato è una buona intenzione, non ancora una strategia di continuità.
La decisione più importante arriva prima del primo comando
Davanti a RECOVERY_PENDING, la sequenza che seguo è semplice: ERRORLOG, risorse, file, backup e solo dopo riparazione. Se la causa è un volume indisponibile o un permesso errato, correggere l’infrastruttura può riportare il database online senza perdita di dati.
Quando invece emergono corruzione o errori I/O persistenti, il restore da una copia verificata resta la strada più solida. La riparazione d’emergenza ha senso solo come ultima possibilità, con la consapevolezza che recuperare l’accesso al database non significa necessariamente recuperare ogni dato.