Un pagamento che aggiorna il saldo ma non registra l’ordine, oppure una prenotazione salvata senza ridurre la disponibilità, può lasciare il database in uno stato incoerente. Una transazione SQL serve proprio a trattare più operazioni come un’unica unità logica, con la possibilità di confermarle tutte o annullarle in caso di errore. In questa guida mostro come funziona, quando usare COMMIT e ROLLBACK, come gestire gli errori e quale livello di isolamento scegliere.
Le regole essenziali per usare bene le transazioni SQL
- Una sola unità logica: tutte le operazioni collegate vengono confermate insieme.
- COMMIT rende definitive le modifiche, mentre ROLLBACK le annulla.
- Le proprietà ACID proteggono integrità, affidabilità e prevedibilità dei dati.
- Autocommit può chiudere automaticamente ogni istruzione e impedire transazioni multi-step.
- Il livello di isolamento è un compromesso tra concorrenza, consistenza e prestazioni.
Perché una transazione SQL protegge i dati
Una transazione raggruppa una sequenza di comandi che deve essere trattata come un blocco unico. Penso a un trasferimento bancario: il database deve sottrarre 100 euro dal conto A e aggiungerli al conto B. Se la seconda operazione fallisce, la prima non può restare attiva da sola.
Il vantaggio concreto è la possibilità di tornare allo stato precedente quando qualcosa va storto. In pratica, il database conserva la coerenza anche davanti a errori applicativi, timeout o interruzioni della connessione, purché la transazione sia stata progettata correttamente.
Le quattro proprietà ACID
| Proprietà | Significato pratico |
|---|---|
| Atomicità | La transazione viene applicata interamente oppure annullata. |
| Consistenza | I dati devono rispettare vincoli e regole prima e dopo l’operazione. |
| Isolamento | Le transazioni concorrenti non devono interferire in modo imprevedibile. |
| Durabilità | Dopo il commit, le modifiche restano disponibili anche dopo un riavvio. |
ACID non significa che ogni transazione sia automaticamente perfetta. Se il codice aggiorna dati sbagliati o sceglie un isolamento eccessivamente aggressivo, il database può comunque produrre risultati indesiderati. La transazione protegge il processo, non corregge la logica dell’applicazione.
Come si apre, conferma e annulla una transazione
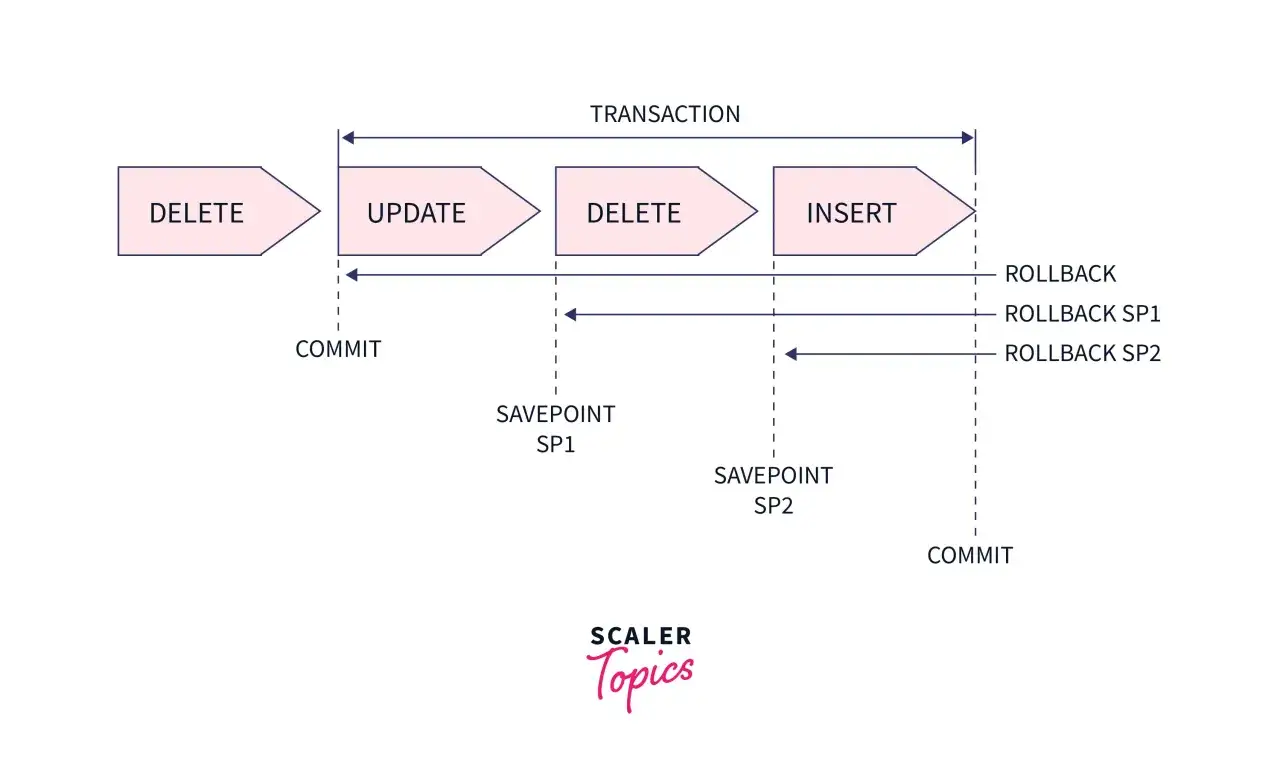
Il ciclo di base è semplice. Si avvia il blocco con BEGIN o START TRANSACTION, si eseguono le istruzioni necessarie e si termina con COMMIT oppure ROLLBACK. La sintassi precisa può cambiare leggermente tra PostgreSQL, MySQL, SQL Server e Oracle.
BEGIN;

UPDATE conti
SET saldo = saldo - 100
WHERE id = 1 AND saldo >= 100;

UPDATE conti
SET saldo = saldo + 100
WHERE id = 2;

COMMIT;
Questo esempio è valido solo se entrambe le modifiche hanno davvero prodotto il risultato previsto. In un’applicazione reale controllo anche il numero di righe aggiornate e gli eventuali errori restituiti dal driver. Se il saldo non è sufficiente o il conto destinatario non esiste, scelgo il rollback.
BEGIN;

UPDATE conti
SET saldo = saldo - 100
WHERE id = 1 AND saldo >= 100;

-- Se una condizione non è rispettata
ROLLBACK;
Savepoint per annullare solo una parte
Quando il flusso è più articolato, un SAVEPOINT permette di tornare indietro fino a un punto intermedio senza cancellare tutto il lavoro precedente. È utile, per esempio, quando una procedura prova più alternative ma deve mantenere le operazioni già riuscite.
BEGIN;

INSERT INTO ordini (cliente_id, totale)
VALUES (25, 89.90);

SAVEPOINT dopo_ordine;

INSERT INTO coupon_usati (codice, cliente_id)
VALUES ('BENVENUTO10', 25);

-- Se il coupon non è valido
ROLLBACK TO SAVEPOINT dopo_ordine;

COMMIT;
Io uso i savepoint con moderazione. Rendono il flusso più flessibile, ma aumentano la complessità del codice e non sostituiscono una gestione chiara degli errori.
Autocommit ed errori possono cambiare completamente il risultato
La modalità autocommit conferma automaticamente ogni istruzione. È comoda per query semplici, ma può essere pericolosa quando due o più comandi devono riuscire insieme. In MySQL, per esempio, l’autocommit è attivo per impostazione predefinita, mentre il comportamento può dipendere dalla configurazione del database e dal driver usato dall’applicazione.
Un errore frequente consiste nel disattivare l’autocommit senza garantire che ogni percorso del codice termini con COMMIT o ROLLBACK. Una connessione lasciata in sospeso può mantenere blocchi sulle righe, rallentare altre richieste e aumentare il rischio di deadlock.
Leggi anche: SQL COLLATE spiegato bene e senza errori
Gestione corretta dal codice applicativo
- Apri la transazione prima della prima operazione collegata.
- Esegui tutte le query usando la stessa connessione.
- Controlla errori e risultati intermedi.
- Esegui
COMMITsolo quando ogni passaggio è riuscito. - Nel blocco di errore usa
ROLLBACKe libera sempre la connessione.
La stessa connessione è un dettaglio decisivo. Se l’inserimento dell’ordine avviene su una connessione e l’aggiornamento del magazzino su un’altra, non hai più una singola transazione locale, anche se le istruzioni sono state scritte una dopo l’altra.
Per operazioni che coinvolgono servizi esterni, come un gateway di pagamento o un sistema di spedizione, una transazione SQL non può annullare automaticamente ciò che è già successo fuori dal database. In questi casi servono strategie come stato intermedio, retry controllati e transazioni compensative.
Livelli di isolamento e concorrenza tra transazioni
Due utenti possono leggere o modificare gli stessi dati nello stesso momento. Il livello di isolamento stabilisce quanto una transazione debba vedere le modifiche delle altre e quali anomalie siano accettabili. Più isolamento offre maggiore prevedibilità, ma spesso aumenta attese, lock e consumo di risorse.
| Livello | Comportamento | Uso tipico |
|---|---|---|
| READ UNCOMMITTED | Può leggere dati non ancora confermati. | Raramente adatto a dati importanti. |
| READ COMMITTED | Legge solo dati confermati, ma una seconda lettura può cambiare. | Buon compromesso per molte applicazioni. |
| REPEATABLE READ | Mantiene più stabile ciò che la transazione legge. | Scenari con letture ripetute e flussi sensibili. |
| SERIALIZABLE | Avvicina l’esecuzione a una sequenza completamente seriale. | Operazioni critiche, accettando più attese. |
Non imposto automaticamente SERIALIZABLE “per sicurezza”. In sistemi con molte richieste concorrenti può ridurre il throughput e generare più conflitti. Di solito parto dal livello predefinito del motore, misuro il comportamento e aumento l’isolamento solo quando il caso d’uso lo richiede davvero.
Quando due transazioni si bloccano a vicenda si verifica un deadlock. Il database ne interrompe normalmente una, quindi il codice deve saper riconoscere l’errore e riprovare l’operazione con un numero limitato di tentativi e un breve backoff.
Gli errori più comuni da evitare in produzione
Il primo errore è tenere una transazione aperta durante attività lente, come chiamate HTTP, elaborazioni di file o attese dell’utente. I lock restano attivi più a lungo e il database può degradare rapidamente sotto carico.
Il secondo è confondere il fatto che una query sia riuscita con il fatto che l’intero processo sia riuscito. Un INSERT corretto non basta se il successivo aggiornamento fallisce. La decisione di confermare deve arrivare solo alla fine del blocco logico.
- Transazioni troppo lunghe: riduci al minimo il lavoro svolto tra apertura e commit.
- Query senza indice: una scansione lenta può trattenere lock e connessioni.
- Rollback assente: ogni eccezione deve chiudere esplicitamente la transazione.
- Connessioni condivise male: una transazione non deve passare casualmente da un thread all’altro.
- Retry ciechi: ripetere un’operazione non idempotente può creare duplicati.
Per rendere un retry sicuro, uso chiavi idempotenti o vincoli unici. Per esempio, un pagamento può avere un identificativo univoco che impedisce di registrarlo due volte anche se la richiesta viene ripetuta dopo un timeout.
Controllo anche i log del database, la durata media delle transazioni, il numero di rollback e i deadlock. Questi indicatori raccontano molto più di una semplice verifica “la query ha restituito un risultato”.
Il criterio pratico per decidere quando usarla
Una transazione è quasi sempre indicata quando più modifiche descrivono un unico evento di dominio, come creare un ordine e scalarne le giacenze. È meno utile racchiudere in un unico blocco operazioni indipendenti, perché si allunga inutilmente il tempo di lock.
La regola che seguo è semplice: se una parte del processo non può esistere senza l’altra, le operazioni devono condividere la stessa transazione. Se invece il collegamento è debole o coinvolge sistemi esterni, conviene progettare stati intermedi e compensazioni.
Una buona transazione SQL non è solo una coppia di comandi BEGIN e COMMIT. È un confine progettato con attenzione tra dati coerenti e dati parziali, sostenuto da controlli, timeout, indici adeguati e una gestione degli errori capace di affrontare anche concorrenza e interruzioni.