Un backup che non parte, un report arrivato in ritardo o una procedura di manutenzione rimasta ferma durante la notte possono trasformarsi rapidamente in un problema operativo. Il servizio SQL Server Agent serve proprio a eseguire automaticamente attività pianificate, con orari, tentativi aggiuntivi, notifiche e controlli sugli errori. In questa guida spiego come funzionano job, passaggi, pianificazioni, autorizzazioni e alert, includendo un esempio pratico in SSMS e T-SQL.
La gestione automatica di SQL Server parte da job ben progettati
- Scopo principale: eseguire backup, manutenzione, report e script secondo una pianificazione.
- Struttura: ogni job contiene uno o più passaggi, una schedule e, se serve, notifiche.
-
Sicurezza: account di servizio, ruoli in
msdbe proxy devono seguire il principio del minimo privilegio. - Controllo: cronologia, retry, alert e operatori permettono di accorgersi rapidamente dei malfunzionamenti.
- Limite principale: è ottimo per attività legate all’istanza SQL, meno adatto ai workflow complessi tra molti sistemi.
Che cos’è SQL Server Agent e quando conviene usarlo
SQL Server Agent è un servizio di Windows integrato nell’ecosistema Microsoft SQL Server. Il suo compito è avviare attività amministrative o applicative senza richiedere l’intervento manuale di un operatore. In pratica, definisco cosa deve essere eseguito, con quale frequenza, con quali credenziali e cosa fare se l’operazione fallisce.
Gli utilizzi più comuni sono i backup automatici, la ricostruzione degli indici, l’aggiornamento delle statistiche, la pulizia delle tabelle temporanee, l’esecuzione di procedure memorizzate e la produzione di file o report. Io lo considero particolarmente utile quando l’attività deve partire direttamente vicino al database e non richiede una lunga orchestrazione tra servizi esterni.
Un job può eseguire codice T-SQL, comandi del sistema operativo, script PowerShell, pacchetti SSIS o altre operazioni supportate dai subsystem disponibili. Questa flessibilità è comoda, ma aumenta anche la superficie di rischio. Un passaggio PowerShell con privilegi eccessivi, per esempio, può fare molto più di quanto serva davvero al database.
SQL Server Agent, SQL Server e Azure SQL
Su un’istanza SQL Server tradizionale, il servizio viene gestito normalmente da SQL Server Management Studio, abbreviato in SSMS. Il nodo “SQL Server Agent” compare nell’Object Explorer quando l’utente dispone dei permessi necessari e il servizio è installato e avviato.
Azure SQL Managed Instance supporta gran parte delle funzioni dell’Agent, ma non tutte le caratteristiche coincidono con quelle di SQL Server installato localmente. Azure SQL Database, invece, segue un modello di automazione differente. Prima di progettare una migrazione conviene quindi verificare la compatibilità dei job, dei subsystem e delle notifiche che si intendono usare.
Come è fatto un job e cosa succede durante l’esecuzione
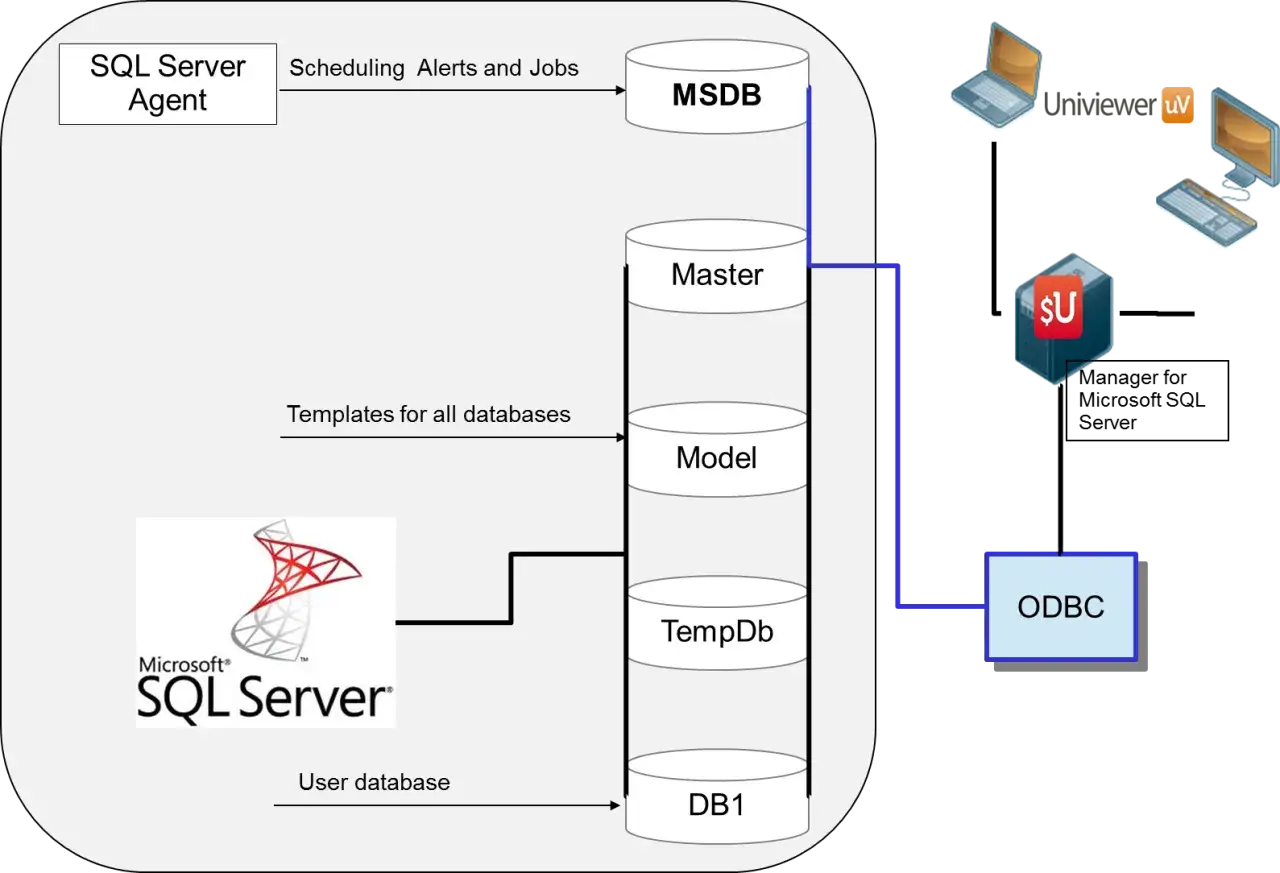
Il componente centrale è il job, cioè una definizione di lavoro salvata nell’istanza. Un job non è soltanto uno script con un orario. Comprende diversi elementi che determinano il comportamento dell’esecuzione e il modo in cui viene registrato il risultato.
| Elemento | Funzione | Esempio |
|---|---|---|
| Job | Raggruppa l’attività automatica | Backup notturno del database |
| Job step | Definisce un’azione concreta | Eseguire una stored procedure T-SQL |
| Schedule | Stabilisce quando avviare il job | Ogni giorno alle 01:00 |
| Retry | Ripete il passaggio dopo un errore | Tre tentativi a distanza di cinque minuti |
| Operator | Riceve una notifica sull’esito | Gruppo email del team database |
| Proxy | Fornisce credenziali limitate a un job step | Eseguire uno script PowerShell senza usare sysadmin |
Un job può contenere più passaggi collegati da condizioni. Per esempio, il primo step può controllare lo spazio disponibile, il secondo eseguire il backup e il terzo registrare l’esito in una tabella di controllo. Se il primo fallisce, posso interrompere l’intera sequenza oppure indirizzarla verso un passaggio di gestione dell’errore.
Questa logica è più importante dell’orario in sé. Nella mia esperienza, molti job sembrano funzionare perché partono regolarmente, ma producono risultati inutili quando non verificano l’esito del passaggio precedente o non controllano la presenza del file generato.
Come creare una pianificazione affidabile
Da SSMS il percorso è lineare. Si apre l’istanza, si espande SQL Server Agent, si entra nella cartella Jobs e si crea un nuovo job. Nella scheda Steps si definisce l’azione, nella scheda Schedules si stabilisce la frequenza e nelle sezioni Notifications e Alerts si decide come reagire ai problemi.
- Creare il job con un nome riconoscibile, indicando anche ambiente e funzione.
- Aggiungere il primo step e selezionare il subsystem corretto, per esempio
Transact-SQL script (T-SQL). - Impostare il database di esecuzione e verificare il codice in modo indipendente.
- Definire la schedule con frequenza, ora di avvio e data di validità.
- Configurare retry e azioni successive in caso di successo o fallimento.
- Salvare il job e avviarlo manualmente almeno una volta in un ambiente controllato.
Per un’attività di manutenzione notturna, una pianificazione giornaliera alle 01:00 può essere ragionevole solo se il carico applicativo è basso in quella fascia. Non esiste un orario universalmente corretto. Il punto è osservare durata, finestre di backup, replica, ETL e processi applicativi che potrebbero competere per CPU, memoria o I/O.
Un esempio con T-SQL
Il seguente esempio crea un job che esegue un backup completo ogni notte alle 01:00. Il percorso deve esistere sul server che esegue SQL Server e l’account del servizio deve avere il permesso di scrittura.
USE msdb;
GO

EXEC dbo.sp_add_job
    @job_name = N'Backup quotidiano Archivio';

EXEC dbo.sp_add_jobstep
    @job_name = N'Backup quotidiano Archivio',
    @step_name = N'Backup completo',
    @subsystem = N'TSQL',
    @database_name = N'Archivio',
    @command = N'
        BACKUP DATABASE [Archivio]
        TO DISK = N''D:\Backup\Archivio_full.bak''
        WITH INIT, COMPRESSION, CHECKSUM;
    ';

EXEC dbo.sp_add_schedule
    @schedule_name = N'Ogni notte alle 01',
    @freq_type = 4,
    @freq_interval = 1,
    @active_start_time = 010000;

EXEC dbo.sp_attach_schedule
    @job_name = N'Backup quotidiano Archivio',
    @schedule_name = N'Ogni notte alle 01';

EXEC dbo.sp_add_jobserver
    @job_name = N'Backup quotidiano Archivio';
GO
Il parametro WITH CHECKSUM aggiunge una verifica sui checksum disponibili durante il backup, mentre COMPRESSION può ridurre lo spazio occupato e il traffico di scrittura. Nessuna delle due opzioni sostituisce però una strategia di ripristino testata: un backup valido è utile soltanto se riesco davvero a recuperare i dati.
Per job più delicati preferisco separare le responsabilità. Un’attività può creare il backup, una seconda verificare che il file abbia dimensioni plausibili e una terza copiare il risultato verso uno storage diverso. In questo modo un job verde non nasconde automaticamente un processo incompleto.
Permessi, account di servizio e proxy
La sicurezza è il punto in cui una configurazione veloce può diventare una cattiva configurazione. L’account con cui gira il servizio non dovrebbe avere automaticamente più privilegi di quelli necessari. Per un backup locale, ad esempio, servono accesso al database e scrittura nella cartella di destinazione, non necessariamente diritti amministrativi sull’intero server.
Gli utenti non appartenenti a sysadmin possono essere inseriti in uno dei tre ruoli fissi di msdb. I ruoli hanno autorizzazioni progressive e vanno scelti in base alla responsabilità reale.
| Ruolo | Uso tipico | Limite importante |
|---|---|---|
SQLAgentUserRole |
Gestire i propri job e le proprie schedule | Non offre una visione completa dei job dell’istanza |
SQLAgentReaderRole |
Consultare job, proprietà e cronologia in modo più ampio | Non equivale ai privilegi di amministrazione |
SQLAgentOperatorRole |
Avviare, fermare o abilitare job locali | Non consente di cambiare liberamente la proprietà dei job |
Questi ruoli sono conservativi per una ragione. Un membro di SQLAgentOperatorRole può gestire molti job, ma non dovrebbe automaticamente poter modificare il codice di ogni processo. L’accesso operativo e l’accesso alla modifica sono responsabilità diverse.
Quando un passaggio deve eseguire PowerShell, SSIS o un comando esterno, uso un proxy. Il proxy associa un job step a credenziali specifiche e autorizzate per quel subsystem. È una soluzione molto più controllabile rispetto all’esecuzione di tutto con l’account del servizio Agent.
Un errore frequente consiste nel testare lo script con il proprio account e poi aspettarsi che funzioni identicamente durante la schedulazione. Il job viene eseguito dal servizio o dal proxy, non dalla sessione interattiva dell’amministratore. Percorsi di rete, variabili d’ambiente, permessi sulle cartelle e autenticazione possono quindi cambiare completamente il risultato.
Alert e monitoraggio per non scoprire gli errori troppo tardi
Un job senza monitoraggio è soltanto un’ipotesi di automazione. Nella configurazione minima imposto una notifica per il fallimento, salvo la cronologia e verifico periodicamente la durata. Per processi critici posso aggiungere una notifica anche quando il job termina con successo, ma solo se il volume di messaggi resta gestibile.
Gli operatori sono persone o gruppi che ricevono le notifiche dell’Agent. Per l’invio tramite email occorre predisporre Database Mail e un profilo utilizzabile dal servizio. Conviene poi verificare l’invio con un test reale, perché una notifica configurata ma mai provata offre una falsa sensazione di controllo.
Leggi anche: API informatiche - come funzionano e quale approccio scegliere
Gestire i fallimenti in modo utile
- Impostare da 1 a 3 retry per errori transitori, come una breve indisponibilità di una risorsa.
- Non usare retry per errori logici, come una tabella mancante o un percorso sbagliato.
- Registrare in una tabella di controllo l’orario di avvio, fine, esito e messaggio.
- Conservare la cronologia per un periodo coerente con le esigenze operative e di audit.
- Controllare la crescita dei log e dei file prodotti, non soltanto il codice di ritorno.
Un retry ha senso quando il problema può risolversi da solo. Se una query fallisce perché manca una colonna, ripeterla tre volte non migliora nulla e può soltanto ritardare l’avviso. Preferisco distinguere chiaramente tra errore temporaneo ed errore strutturale, anche quando questo richiede uno step di controllo aggiuntivo.
La cronologia dei job è utile per capire se un processo sta diventando più lento. Un backup che impiegava 12 minuti e ora ne richiede 45 non è necessariamente fallito, ma segnala una tendenza da indagare prima che rompa la finestra operativa.
Limiti e alternative da valutare nel 2026
SQL Server Agent è molto efficace quando il centro dell’automazione è un’istanza SQL Server. Diventa meno comodo quando il workflow deve coordinare API, code, container, risorse cloud, approvazioni manuali o numerosi sistemi eterogenei.
| Scenario | Scelta generalmente adatta | Motivo |
|---|---|---|
| Backup e manutenzione dell’istanza | SQL Server Agent | È vicino al database e gestisce bene schedule, retry e cronologia |
| Pipeline ETL tra più fonti cloud | Servizio di orchestrazione dati | Offre connettori, dipendenze e monitoraggio distribuito |
| Script amministrativi su Windows | Agent o Utilità di pianificazione | La scelta dipende da quanto il processo è legato a SQL Server |
| Workflow con API e approvazioni | Orchestratore dedicato | Gestisce meglio stati, timeout e integrazioni esterne |
Non sostituirei l’Agent solo perché esistono strumenti cloud più moderni. Per un database on-premises con backup, manutenzione e controlli giornalieri, introdurre un orchestratore esterno può aggiungere complessità senza un vantaggio concreto. Al contrario, per una pipeline che deve coordinare database, storage, API e notifiche su più ambienti, insistere con decine di job indipendenti può diventare difficile da mantenere.
Un’altra limitazione riguarda la dipendenza dall’istanza. Se SQL Server Agent è fermo, i job locali non partono. Per questo controllo lo stato del servizio, configuro il riavvio secondo le regole dell’ambiente e considero una verifica esterna per i processi davvero critici.
Su Azure SQL Managed Instance occorre inoltre verificare le funzioni supportate prima della migrazione. Nomi, subsystem, proxy e modalità di autenticazione possono richiedere adattamenti. La compatibilità va testata con un job rappresentativo, non dedotta soltanto dal fatto che entrambe le piattaforme usano SQL Server.
La configurazione che userei per partire senza sorprese
Per un ambiente piccolo partirei con pochi job leggibili, nomi coerenti e una sola responsabilità per processo. Imposterei backup, controllo dell’esito, pulizia della cronologia e notifiche di errore, poi verificherei un ripristino prima di aggiungere automazioni più elaborate.
Il risultato migliore non nasce dal numero di job creati, ma dalla loro osservabilità. Ogni attività dovrebbe indicare chiaramente cosa fa, con quale account gira, dove registra l’esito e chi riceve l’avviso. Con queste basi, SQL Server Agent rimane uno strumento solido per trasformare la manutenzione ripetitiva in un processo prevedibile e verificabile.