Quando un gestionale deve leggere dati da un’altra istanza SQL Server, da Oracle o perfino da una sorgente OLE DB, un linked server può evitare di costruire subito un’integrazione applicativa complessa. In questa guida mostro come funziona il collegamento, come configurarlo con SSMS o T-SQL, quali query usare e dove si nascondono i problemi più comuni di sicurezza e prestazioni.
Il collegamento remoto funziona bene quando il perimetro è chiaro
- Un linked server permette di interrogare sorgenti remote direttamente dal Database Engine.
- La configurazione richiede un provider OLE DB, un nome logico e una mappatura delle credenziali.
- Le query a quattro parti sono immediate, mentre OPENQUERY offre spesso un controllo migliore sull’esecuzione remota.
- La sicurezza non va lasciata alla configurazione predefinita, soprattutto con login SQL e account di servizio.
- Per grandi volumi di dati, un processo ETL o una replica è spesso più adatto di una query distribuita.
Cosa risolve davvero un linked server
Un linked server è una definizione salvata nell’istanza locale che descrive come raggiungere un’altra sorgente dati. Dal punto di vista dello sviluppatore, il sistema remoto assume un nome logico e può essere usato nelle istruzioni Transact-SQL quasi come una risorsa locale.
Il caso più comune consiste nel collegare due istanze SQL Server, ma la tecnologia può lavorare anche con database eterogenei, a condizione che sia disponibile un provider compatibile. Oracle, alcuni driver ODBC tramite il provider appropriato e altre sorgenti OLE DB rientrano negli scenari possibili, anche se il livello di compatibilità dipende sempre dal driver.
Io lo considero una soluzione adatta soprattutto a integrazioni operative leggere: controllare un’anagrafica su un altro server, alimentare un report, verificare un ordine o trasferire un numero limitato di righe. Non lo userei come prima scelta per spostare ogni notte centinaia di milioni di record.
La caratteristica più utile è la possibilità di usare un nome composto da quattro parti:
NomeLinkedServer.Database.Schema.OggettoPer esempio:
SELECT TOP (100)
       o.OrderID,
       o.OrderDate,
       c.CustomerName
FROM ERP_PROD.Sales.dbo.Orders AS o
JOIN CRM_PROD.Customers.dbo.Customer AS c
  ON c.CustomerID = o.CustomerID;
La query sembra locale, ma il motore deve gestire rete, autenticazione, conversioni di tipo e piano di esecuzione distribuito. Questa differenza è il motivo per cui una sintassi semplice non garantisce automaticamente buone prestazioni.
Come configurarlo senza lasciare buchi
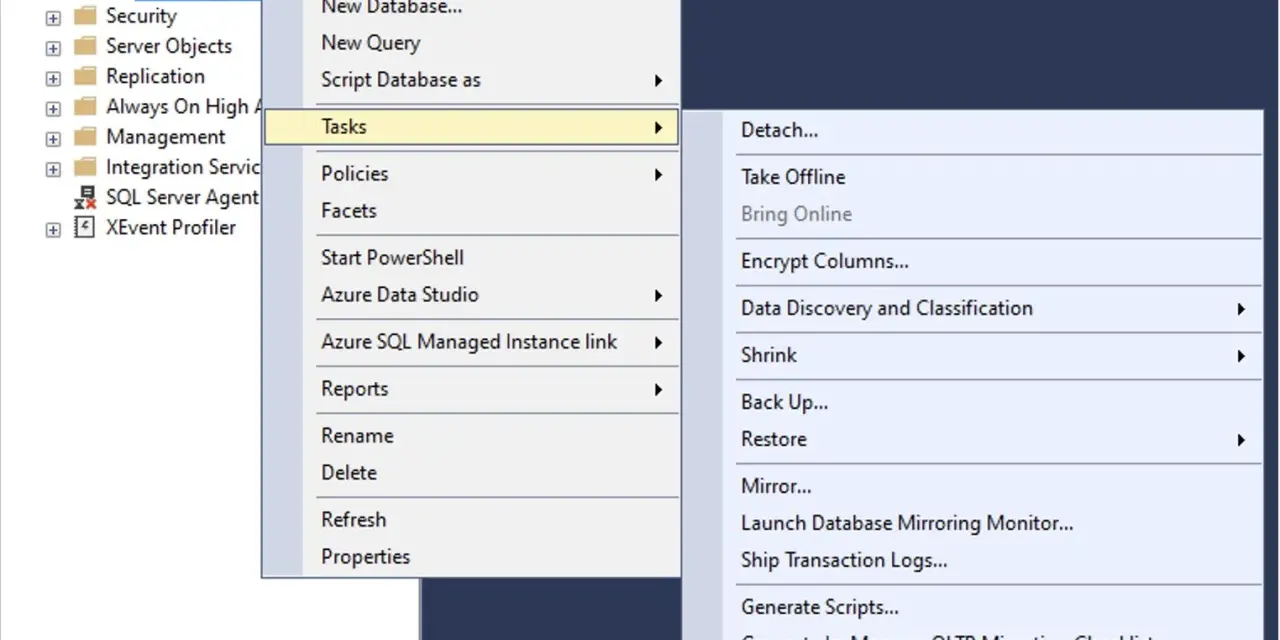
In SQL Server Management Studio si parte da Server Objects, poi si seleziona Linked Servers e New Linked Server. È il percorso più comodo per una prova o per una configurazione manuale, ma in ambienti ripetibili preferisco uno script T-SQL versionato.
Per un’altra istanza SQL Server, una configurazione di base può assomigliare a questa:
USE master;
GO

EXEC sys.sp_addlinkedserver
    @server     = N'ERP_PROD',
    @srvproduct = N'',
    @provider   = N'MSOLEDBSQL',
    @datasrc    = N'SQLPROD01\ERP';
GO
Il parametro @server è il nome con cui il collegamento verrà richiamato nelle query. @datasrc identifica l’istanza remota, mentre @provider indica il driver OLE DB usato per la connessione. Nelle versioni moderne è preferibile utilizzare Microsoft OLE DB Driver for SQL Server invece dei vecchi provider Native Client.
Con Microsoft OLE DB Driver 19, usato negli scenari più recenti, la gestione della cifratura deve essere esplicita. In produzione conviene predisporre un certificato valido; impostare la cifratura come opzionale può essere utile in laboratorio, ma non dovrebbe diventare una scorciatoia permanente.
Dopo aver creato il collegamento, verifico sempre la raggiungibilità con una query minima:
EXEC master.dbo.sp_testlinkedserver
    @servername = N'ERP_PROD';

SELECT name
FROM ERP_PROD.master.sys.databases;
Se il test passa ma la lettura di una tabella fallisce, il problema non è necessariamente la rete. Spesso mancano il database corretto, i permessi sullo schema o una mappatura valida tra login locale e login remoto.
La configurazione della sicurezza
La procedura sp_addlinkedsrvlogin definisce quale identità usare sul server remoto. Un esempio con un account dedicato è:
EXEC master.dbo.sp_addlinkedsrvlogin
    @rmtsrvname  = N'ERP_PROD',
    @useself     = N'False',
    @locallogin  = NULL,
    @rmtuser     = N'report_reader',
    @rmtpassword = N'PasswordDaGestireInModoSicuro';
La mappatura globale con @locallogin = NULL è comoda, ma amplia il perimetro. In un ambiente sensibile preferisco associare solo i login locali che ne hanno realmente bisogno e concedere all’account remoto esclusivamente i permessi di lettura necessari.
Con l’autenticazione Windows si può tentare di usare il contesto corrente, ma entrano in gioco delega Kerberos, SPN e account di servizio. Il classico problema del double hop nasce proprio quando il server locale deve inoltrare le credenziali dell’utente a un secondo server. Se la configurazione non è curata, il collegamento funziona con l’amministratore e fallisce con l’account dell’applicazione.
Tre modi per interrogare la sorgente remota
La scelta della sintassi influisce sia sulla leggibilità sia sulla quantità di lavoro che resta al server locale. Io parto dalle query a quattro parti per i casi semplici, poi passo a OPENQUERY quando voglio spingere il filtro verso la sorgente remota.
Nomi a quattro parti
SELECT
    p.ProductID,
    p.ProductName,
    p.Price
FROM ERP_PROD.Inventory.dbo.Products AS p
WHERE p.IsActive = 1;
È il metodo più diretto e si integra bene con join, viste e procedure locali. Il limite è che il query optimizer può stimare male la quantità di dati remoti e trasferire più righe del necessario, soprattutto quando la query include join complessi o funzioni non supportate dal provider.
OPENQUERY per eseguire il filtro da remoto
SELECT *
FROM OPENQUERY(
    ERP_PROD,
    'SELECT ProductID, ProductName, Price
     FROM Inventory.dbo.Products
     WHERE IsActive = 1'
);
Con OPENQUERY il testo SQL viene inviato direttamente al linked server. Questo è spesso vantaggioso perché il filtro viene applicato vicino ai dati e sulla rete viaggiano meno righe. Il rovescio della medaglia è che la query è una stringa, quindi parametri, apici e SQL dinamico richiedono maggiore attenzione.
EXEC AT per comandi dinamici
EXEC (N'
    SELECT COUNT(*)
    FROM Inventory.dbo.Products
    WHERE IsActive = 1
') AT ERP_PROD;
EXEC AT è utile quando il comando deve essere costruito dinamicamente o quando si lavora con stored procedure remote. Lo uso con cautela, perché il SQL dinamico rende più difficile controllare input, permessi e comportamento del piano di esecuzione.
Le operazioni di scrittura sono possibili, ma le tratto come un caso separato. Prima di usare INSERT, UPDATE o DELETE verifico che il provider supporti davvero l’operazione, che le transazioni siano comprese e che un errore a metà non lasci i due sistemi in uno stato incoerente.
Sicurezza e autenticazione richiedono una scelta consapevole
Il punto più sottovalutato non è la creazione del collegamento, ma chi può usarlo e con quali privilegi. Un linked server può diventare un ponte laterale verso database che non dovrebbero essere accessibili a ogni login dell’istanza locale.
Per una configurazione ordinata applico generalmente queste regole:
- uso un account remoto dedicato, con permessi limitati alle sole tabelle o viste necessarie;
- evito di lasciare una mappatura globale se solo una procedura o un login deve accedere alla sorgente;
- preferisco viste remote già filtrate quando gli utenti non devono vedere tutte le colonne;
- registro chi esegue query distribuite e quali oggetti vengono raggiunti;
- mantengo aggiornati provider, patch di SQL Server e certificati TLS;
- non inserisco password in script condivisi o repository.
Un errore frequente consiste nel concedere sysadmin sul server remoto per “far funzionare il collegamento”. È una soluzione rapida solo in apparenza. Se il problema è una mappatura, un database non accessibile o un provider mal configurato, aumentare i privilegi nasconde la causa e crea un rischio molto più grande.
Per SQL Server in Azure bisogna distinguere i servizi. I linked server sono disponibili nel Database Engine tradizionale e in Azure SQL Managed Instance con alcune limitazioni, mentre Azure SQL Database non offre la stessa funzionalità dei linked server classici. In quel caso vanno valutate alternative come elastic query, pipeline o connessioni gestite dall’applicazione.
Prestazioni e limiti che si vedono solo in produzione
Una query distribuita attraversa almeno due sistemi e una rete. Anche se entrambe le istanze sono veloci, il tempo totale può crescere per latenza, cardinalità stimata male, conversioni di tipo o trasferimento di troppe righe.
Le precauzioni che danno il risultato più concreto sono semplici:
- selezionare solo le colonne necessarie invece di usare SELECT *;
- filtrare il più vicino possibile alla sorgente remota;
- usare indici sul server che conserva i dati filtrati o collegati;
- evitare join distribuiti su tabelle molto grandi;
- materializzare localmente i dati se vengono letti più volte nello stesso processo;
- misurare tempi, righe trasferite e piano di esecuzione con dati realistici.
Per esempio, se devo importare gli ordini dell’ultima giornata, preferisco inviare una query remota già filtrata:
SELECT *
FROM OPENQUERY(
    ERP_PROD,
    'SELECT OrderID, CustomerID, OrderDate, TotalAmount
     FROM Sales.dbo.Orders
     WHERE OrderDate >= DATEADD(day, -1, CONVERT(date, GETDATE()))'
);
In scenari di reporting, però, una data calcolata sul server remoto può creare differenze di fuso orario o di calendario. Per processi importanti conviene definire chiaramente l’intervallo temporale e usare timestamp in UTC, così il risultato non cambia in modo inatteso durante l’ora legale.
Leggi anche: Come installare Python su Windows, macOS e Linux senza errori
Quando il linked server non è la scelta giusta
Se l’obiettivo è sincronizzare stabilmente due sistemi, preferisco valutare SSIS, Azure Data Factory, CDC, replica o un processo applicativo. Queste soluzioni aggiungono progettazione, ma offrono controllo su retry, monitoraggio, trasformazioni e disaccoppiamento dalla disponibilità del database remoto.
Un linked server è invece ragionevole quando servono dati quasi in tempo reale, il volume è contenuto e il collegamento può restare semplice. Il criterio pratico è questo: se un guasto temporaneo al sistema remoto deve bloccare il sistema locale, probabilmente la dipendenza è diventata troppo stretta.
Errori tipici e metodo rapido per risolverli
Quando una query fallisce, non parto modificando casualmente provider e opzioni. Divido il problema in quattro livelli: rete, provider, autenticazione e autorizzazioni. Questa sequenza riduce molto il tempo perso nei casi in cui il messaggio di errore è poco preciso.
| Problema | Controllo da fare | Correzione probabile |
|---|---|---|
| Server remoto non raggiungibile | Nome DNS, porta, firewall e istanza | Correggere endpoint o regole di rete |
| Provider non trovato | Driver installato sul server SQL | Installare o aggiornare il provider compatibile |
| Accesso negato | Mappatura del login e login remoto | Configurare sp_addlinkedsrvlogin e i permessi |
| Tabella inesistente | Nome a quattro parti, database e schema | Verificare catalogo e nomenclatura dell’oggetto |
| Query molto lenta | Piano, filtri e righe trasferite | Usare OPENQUERY, indici o staging locale |
| Errore di transazione distribuita | MSDTC e supporto del provider | Ridurre il perimetro transazionale o configurare MSDTC |
Gli errori di autenticazione sono spesso legati al contesto di esecuzione. Una query lanciata da SSMS con il mio account Windows può funzionare, mentre la stessa query eseguita da SQL Server Agent fallisce perché il job usa un account diverso. Per questo testo sempre il collegamento con la stessa identità del processo reale.
Le transazioni distribuite meritano prudenza. Quando un’operazione coinvolge due server, SQL Server può richiedere Microsoft Distributed Transaction Coordinator, cioè MSDTC. Firewall, autenticazione e configurazione dei due nodi devono essere coerenti, e non tutti i provider gestiscono allo stesso modo il commit distribuito.
La regola pratica per decidere senza complicare l’architettura
Per una lettura occasionale o per un’integrazione con pochi dati, un linked server ben configurato resta una soluzione efficace e veloce da mettere in opera. Per uso continuativo scelgo invece un account dedicato, query filtrate in remoto, monitoraggio e un piano alternativo nel caso il server dipendente non risponda.
La mia verifica finale comprende sempre tre domande: quanti dati attraversano la rete, quale identità li legge e cosa succede se la sorgente è offline. Se le risposte sono misurabili e accettabili, il collegamento può essere una scelta concreta. Se invece serve sincronizzazione, resilienza o grandi volumi, è più sano spostare l’integrazione in una pipeline progettata per quel lavoro.