Quando un’applicazione deve scambiare dati con un sito, un gestionale o un servizio cloud, la qualità dell’API determina spesso la stabilità dell’intero progetto. Le API RESTful offrono un modello semplice e scalabile per collegare client, server e database, ma funzionano bene solo quando risorse, metodi HTTP, sicurezza e gestione degli errori sono progettati con criterio.
Le idee essenziali per capire e progettare API RESTful efficaci
- REST è uno stile architetturale, non un linguaggio né un protocollo autonomo.
- Le risorse vengono esposte attraverso URL coerenti e manipolate con GET, POST, PUT, PATCH e DELETE.
- La comunicazione è normalmente stateless: ogni richiesta contiene le informazioni necessarie per essere elaborata.
- Un buon design richiede status code corretti, paginazione, validazione e versionamento.
- REST è spesso una scelta eccellente per applicazioni web e cloud, ma non è sempre la soluzione migliore per streaming o comunicazioni ad alta frequenza.
Che cosa sono davvero le API RESTful
REST significa Representational State Transfer e descrive uno stile per costruire sistemi distribuiti. In pratica, un client invia una richiesta HTTP a un server, il server elabora l’operazione e restituisce una rappresentazione della risorsa richiesta, spesso in formato JSON.
Una risorsa può essere un cliente, un ordine, un prodotto o un documento. L’API non dovrebbe presentarla come una tabella interna del database, ma come un oggetto comprensibile dall’esterno. Per esempio, /api/v1/orders/125 identifica l’ordine 125, mentre /api/v1/getOrderById descrive un’azione e rende l’interfaccia meno coerente.
Qui si trova una distinzione che considero importante. Un’API che usa HTTP e JSON non è automaticamente RESTful. Può adottare alcune convenzioni REST senza rispettare pienamente tutti i vincoli dello stile architetturale, soprattutto quello dell’hypermedia. Nel linguaggio quotidiano del settore, però, “API REST” indica spesso un’interfaccia HTTP orientata alle risorse e progettata secondo buone pratiche condivise.
Il flusso di una richiesta
Immaginiamo un’applicazione di e-commerce. Il client chiede l’elenco dei prodotti con una richiesta GET. Il server verifica autenticazione e parametri, interroga il database, applica eventuali filtri e restituisce una risposta con dati e codice HTTP.
GET /api/v1/products?category=books&limit=20
Accept: application/json
La risposta potrebbe contenere una collezione di prodotti, il numero di risultati e i collegamenti alla pagina successiva. La parte importante non è il formato estetico del JSON, ma la presenza di un contratto stabile tra chi consuma l’API e chi la mantiene.
I vincoli REST che fanno la differenza
Il modello REST nasce da alcuni vincoli architetturali. Non sono semplici regole di stile: influenzano scalabilità, manutenzione e comportamento dell’applicazione quando il traffico cresce.
Client e server separati
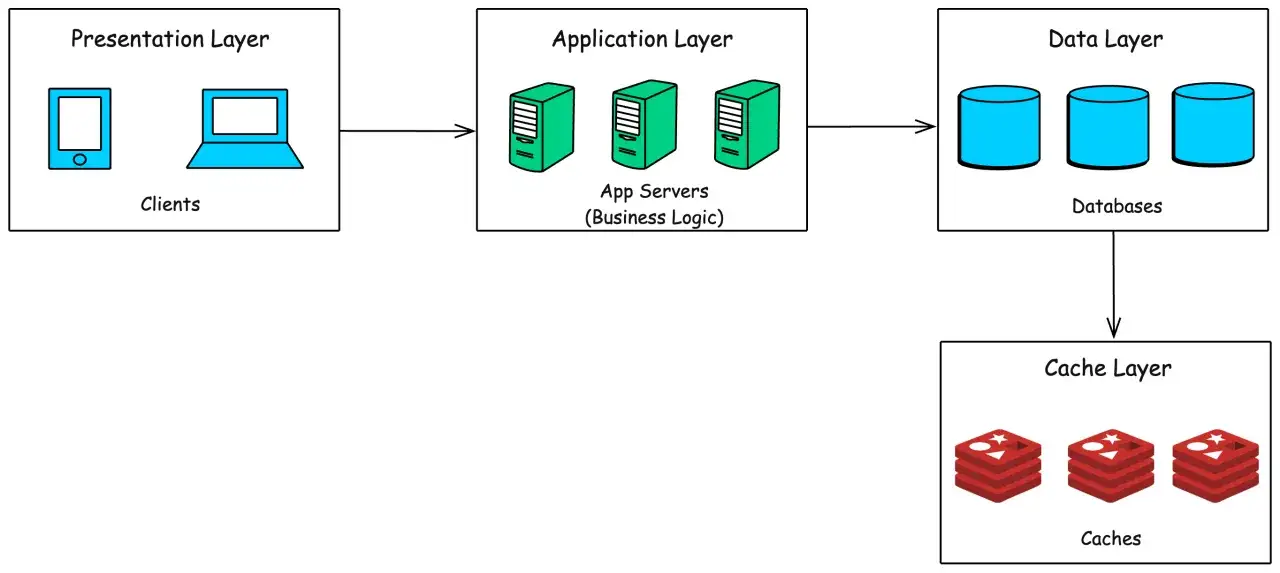
Il client gestisce interfaccia e interazione con l’utente, mentre il server gestisce dati, autorizzazioni e logica applicativa. Questa separazione permette di sostituire una web app con un’app mobile senza riscrivere il database o tutta la logica di backend.
Comunicazione stateless
Ogni richiesta deve contenere le informazioni necessarie per essere elaborata. Il server non dovrebbe dipendere da una sessione locale conservata in memoria per capire il significato della richiesta successiva. Stateless non significa “senza autenticazione”: significa che il contesto deve essere trasmesso, per esempio tramite un token di accesso.
Il vantaggio pratico è notevole. Le richieste possono essere distribuite tra più istanze del servizio senza dover mantenere lo stato dell’utente su un singolo server. Il compromesso è che token e dati di contesto devono essere gestiti con attenzione, soprattutto per evitare rischi di sicurezza.
Interfaccia uniforme
Le risorse dovrebbero essere nominate in modo prevedibile e manipolate con semantica coerente. Un client che conosce il comportamento di GET /products/42 dovrebbe poter intuire il funzionamento di GET /customers/42.
Cache e sistema a livelli
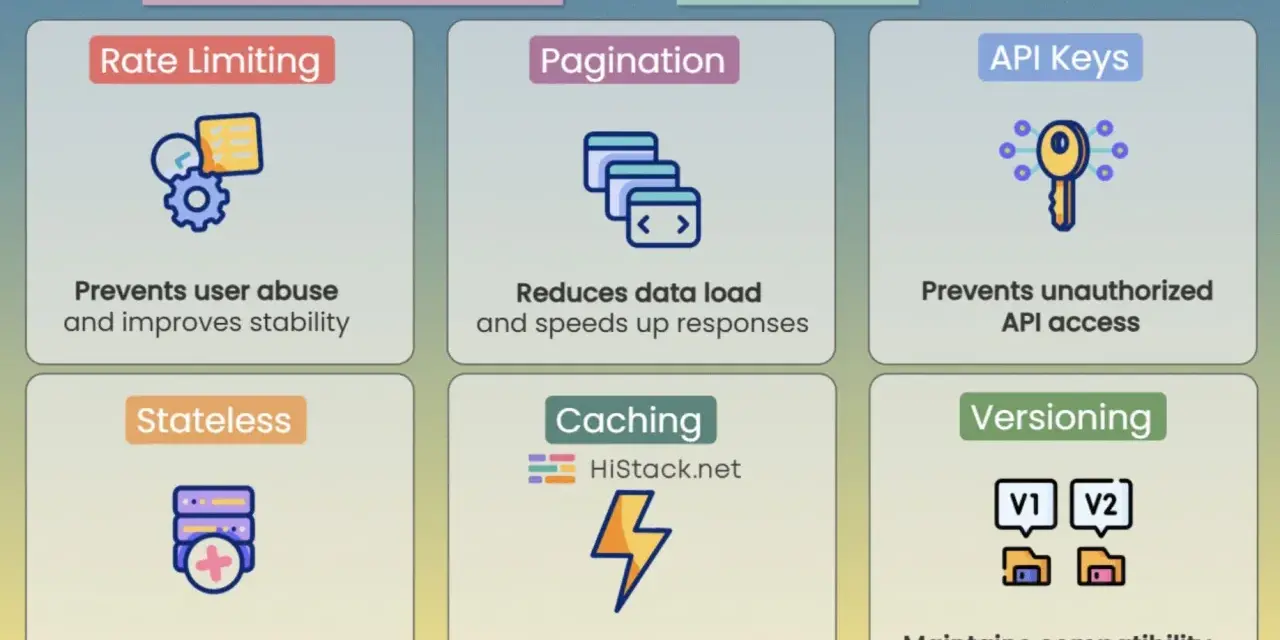
Le risposte possono essere memorizzate nella cache quando i dati lo consentono. Questo riduce il carico sul database e migliora i tempi di risposta, ma non tutti i dati sono adatti alla cache. Un catalogo pubblico può essere memorizzato per alcuni minuti; il saldo di un conto o lo stato di un pagamento richiede invece molta più prudenza.
Il sistema può inoltre includere proxy, gateway, bilanciatori e servizi di autenticazione tra client e server. Questa struttura a livelli è comune nelle architetture cloud, anche se rende indispensabili logging distribuito e tracciamento delle richieste.
Metodi HTTP, risposte e codici di stato
La scelta del metodo HTTP comunica l’intenzione dell’operazione. Usare sempre POST perché “funziona” impoverisce il contratto dell’API e rende più difficile sfruttare cache, retry e strumenti automatici.
| Metodo | Uso principale | Esempio |
|---|---|---|
GET |
Leggere una risorsa | GET /products/42 |
POST |
Creare una risorsa o avviare un’operazione | POST /orders |
PUT |
Sostituire completamente una risorsa | PUT /products/42 |
PATCH |
Modificare solo alcuni campi | PATCH /products/42 |
DELETE |
Eliminare una risorsa | DELETE /products/42 |
PUT e PATCH non sono intercambiabili. Se il client invia una rappresentazione completa dell’oggetto, PUT è generalmente più adatto. Se modifica soltanto il prezzo o la descrizione, PATCH evita di sovrascrivere accidentalmente altri campi.
Gli status code più utili
Una risposta affidabile non restituisce sempre 200 OK. Il codice deve aiutare il client a capire che cosa è successo e se può riprovare.
- 200 OK indica una richiesta elaborata correttamente.
- 201 Created conferma la creazione di una nuova risorsa.
- 204 No Content segnala un’operazione riuscita senza corpo nella risposta.
- 400 Bad Request indica una richiesta malformata.
- 401 Unauthorized indica che manca un’autenticazione valida.
- 403 Forbidden indica che l’identità è riconosciuta, ma non ha il permesso richiesto.
- 404 Not Found segnala che la risorsa non esiste o non è visibile.
- 409 Conflict è utile quando la richiesta entra in conflitto con lo stato attuale dei dati.
- 422 Unprocessable Content descrive dati formalmente validi ma semanticamente errati.
- 429 Too Many Requests segnala il superamento del limite di frequenza.
- 500 e 503 indicano problemi lato server, con differenza tra errore generico e indisponibilità temporanea.
Un errore ben progettato dovrebbe includere un codice applicativo, un messaggio leggibile e, quando possibile, i campi che hanno causato il problema. Evito invece di restituire stack trace o dettagli del database, perché aiutano poco il client e possono rivelare informazioni sensibili.
Come collegare un’API REST a un database
Il database è una parte dell’implementazione, non il contratto pubblico dell’API. Esporre direttamente nomi delle tabelle e colonne porta quasi sempre a un’interfaccia fragile. Se domani si normalizza una tabella o si sposta un campo, tutti i client rischiano di rompersi.
Modellare risorse e relazioni
Una struttura ragionevole può essere questa:
GET    /api/v1/customers
GET    /api/v1/customers/18
GET    /api/v1/customers/18/orders
POST   /api/v1/customers/18/orders
La relazione tra cliente e ordini è leggibile, ma non bisogna trasformare ogni relazione interna in una catena infinita di endpoint. Per dati complessi preferisco includere una rappresentazione sintetica e offrire endpoint specifici per i dettagli. Ridurre il numero di query e la quantità di dati inutili migliora sia le prestazioni sia la comprensione dell’API.
Paginazione, filtri e ordinamento
Restituire migliaia di righe in una sola risposta è una delle scelte più costose e meno lungimiranti. In molti progetti imposto una dimensione predefinita tra 20 e 50 elementi, con un limite massimo esplicito, per esempio 100.
GET /api/v1/orders?status=paid&limit=20&cursor=eyJpZCI6MTIzfQ==Per dataset che cambiano spesso, la paginazione basata su cursore è normalmente più stabile di quella basata solo su numero di pagina. I filtri devono essere documentati e validati, mentre i campi di ordinamento dovrebbero provenire da una lista consentita per evitare query imprevedibili o vulnerabilità.
Transazioni e concorrenza
Un’API può ricevere due richieste quasi contemporaneamente. Se entrambe leggono lo stesso saldo e lo aggiornano senza transazione, il risultato può essere errato. Per operazioni finanziarie o inventari consiglio transazioni database, vincoli di integrità e controllo della concorrenza.
È utile anche gestire l’idempotenza. Una richiesta di pagamento ripetuta dopo un timeout di rete non dovrebbe creare due addebiti. Un header come Idempotency-Key, associato a una chiave conservata dal server, può aiutare a riconoscere e riutilizzare il risultato della prima operazione.
Sicurezza, versionamento e qualità operativa
Una REST API esposta su Internet deve essere trattata come una superficie d’attacco, non come un semplice collegamento tra frontend e backend. La cifratura HTTPS è la base, ma da sola non risolve autenticazione, autorizzazione o abuso del servizio.
Controlli indispensabili
- Usare OAuth 2.0 o OpenID Connect quando serve delegare accesso e identità.
- Limitare ogni token ai permessi realmente necessari.
- Validare tipo, formato, lunghezza e intervalli di ogni input.
- Applicare rate limiting per utente, token o indirizzo di rete.
- Non inserire password, token o dati personali nei log.
- Configurare CORS in modo selettivo, ricordando che CORS non è un meccanismo di autenticazione.
- Monitorare latenza, errori, timeout e percentuale di risposte 4xx e 5xx.
Per il versionamento, /api/v1 nell’URL è facile da capire e da gestire, anche se non è l’unica opzione. Qualunque strategia si scelga, una nuova versione dovrebbe arrivare quando cambia il contratto in modo incompatibile, non per ogni piccola modifica interna.
Leggi anche: Dizionario Python senza errori - guida a chiavi e metodi
Documentazione e test
Un’API senza documentazione costringe gli sviluppatori a indovinare. Una specifica OpenAPI ben mantenuta descrive endpoint, parametri, risposte, autenticazione ed errori, e può alimentare strumenti per test e generazione di client.
Io distinguo almeno tre livelli di verifica. I test unitari controllano la logica, quelli di integrazione verificano database e servizi esterni, mentre i test di contratto controllano che la risposta reale resti compatibile con ciò che il client si aspetta. In produzione aggiungo test di carico, soprattutto sugli endpoint che eseguono query complesse.
Quando REST non è la scelta migliore
REST è una scelta solida per CRUD, portali web, applicazioni mobile, integrazioni tra servizi e prodotti cloud. Non è però una risposta universale. La decisione dovrebbe dipendere dal tipo di comunicazione, dalla frequenza degli scambi e dal controllo che si ha sui client.
| Approccio | Quando conviene | Limite principale |
|---|---|---|
| REST | Risorse pubbliche, CRUD, integrazioni web e cloud | Possibili richieste multiple e payload non sempre ottimali |
| GraphQL | Client che richiedono campi diversi e aggregazioni flessibili | Cache, autorizzazioni e controllo della complessità richiedono più lavoro |
| gRPC | Comunicazione interna ad alte prestazioni tra servizi controllati | Meno immediato per browser e integrazioni pubbliche |
| WebSocket | Aggiornamenti in tempo reale e comunicazione bidirezionale | Gestione di connessioni, riconnessioni e stato più complessa |
Un sistema REST può anche affiancare code asincrone, WebSocket o gRPC. Per esempio, un’API può creare un’elaborazione con POST, restituire 202 Accepted e permettere al client di verificare lo stato tramite una risorsa dedicata. Questo modello è più affidabile di una richiesta HTTP mantenuta aperta per diversi minuti.
Una checklist concreta prima di pubblicare l’API
Prima del rilasciocontrollo che ogni risorsa abbia nomi coerenti, che i metodi HTTP riflettano davvero l’operazione e che i codici di stato siano utilizzabili dal client. Verifico anche i casi meno comodi, come dati mancanti, autorizzazioni insufficienti, record cancellati, richieste duplicate e timeout.
- Gli endpoint rappresentano risorse e non una lunga lista di comandi?
- Le risposte hanno uno schema stabile e documentato?
- Le collezioni supportano paginazione, filtri e limiti?
- Gli errori hanno codici e messaggi coerenti?
- Le operazioni sensibili sono protette da autorizzazione e idempotenza?
- Esistono metriche per latenza, errori e consumo?
- È chiaro come evolvere l’API senza rompere i client esistenti?
La mia esperienza è che la differenza tra un’API appena funzionante e una API realmente affidabile non sta nel numero di endpoint, ma nella qualità delle decisioni ripetute: nomi chiari, contratti prevedibili, errori utili e attenzione al comportamento del database sotto carico.
Il valore di una REST API si vede nei dettagli che resistono alla crescita
Una buona API RESTful rende semplice leggere e modificare risorse senza esporre la complessità interna del sistema. Quando client, server e database restano separati, l’applicazione può evolvere con meno attriti e integrarsi più facilmente con servizi cloud, strumenti di intelligenza artificiale e applicazioni mobili.
Non inseguirei la conformità teorica come obiettivo isolato. Preferisco un’API coerente, sicura, documentata e osservabile, con vincoli REST applicati dove producono un vantaggio concreto. È questa combinazione, più della sola etichetta REST, a determinare la qualità del risultato nel lungo periodo.